Agent에게 바로 개발시키지 않기 — 실무에서 AI 개발을 안정화한 방식
2026.06.25 게시
이 시리즈는 작성 시점의 기록이다. 현재 기준은 Adaptive Agentic SDD 저장소에 정리해두었다.
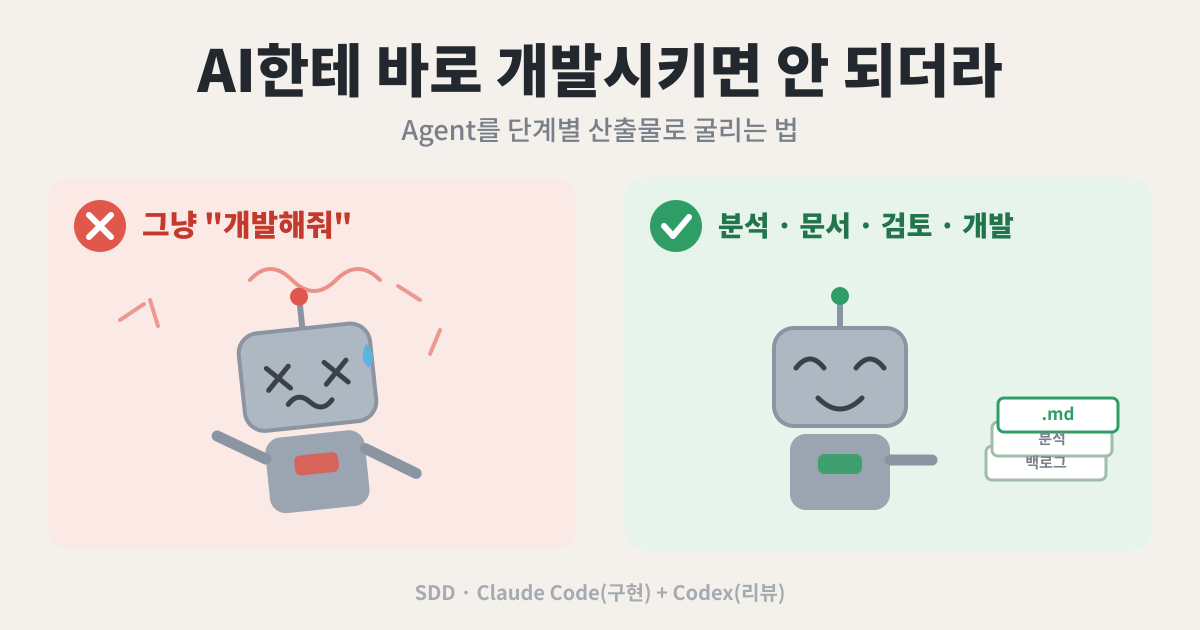
이 글은 “Agent에게 코드를 어떻게 빨리 짜게 할까”가 아니라, “Agent를 실무에 안정적으로 끼워 넣으려면 어떤 절차로 굴려야 하나”에 대한 기록이다.
0. 결론부터
Agent를 실무 개발에 제대로 쓰려면, 좋은 프롬프트 하나보다 좋은 작업 절차가 더 중요하다.
Agent는 코드를 빠르게 만든다. 하지만 실무에서 중요한 건 속도가 아니라 요구사항을 제대로 이해했는지, 영향 범위를 놓치지 않았는지, 변경 대상이 적절한지, 테스트할 항목이 정리됐는지를 확인하는 과정이다. 그래서 나는 Agent에게 바로 “개발해줘”라고 하지 않는다. 먼저 분석시키고, 문서화시키고, 검토한 뒤에 구현시킨다.
물론 모든 작업에 이 절차를 적용하지는 않는다. 단순 오타 수정이나 영향 범위가 파일 하나로 닫히는 작업에까지 md 산출물을 만들면 오히려 오버프로세싱이다. 작업의 규모와 리스크에 따라 절차의 무게를 다르게 가져간다.
이 글은 세 부분으로 나뉜다.
- 1부. 단일 Agent를 안정적으로 쓰는 기본 흐름 (현행 고정 → 변경 설계 → 구현/리뷰)
- 2부. 백로그는 체크리스트가 아니라 세션 밖에 저장된 상태라는 것
- 3부. 구현 Agent와 리뷰 Agent를 분리하고, 병렬화를 검토하는 멀티 에이전트 운영
1부. 단일 Agent를 안정적으로 쓰는 기본 흐름
전제 — 이 절차를 모든 작업에 다 씌우는 건 아니다. 앞서 말한 대로, 작업을 규모·리스크로 등급화해서 등급마다 프로세스 무게를 다르게 가져간다. 산출물을 만들기 시작하는 건 Small 이상부터고, 이 글에서 설명하는 전체 절차는 Medium 이상 작업에 적용하는 방식이다.
오타 수정부터 도메인 구조 변경까지 AI 코딩 작업을 규모와 리스크로 등급화하고, 각 등급에 필요한 절차와 산출물을 정리한 글이다.
Link - AI한테 일을 시킬 때, 다 똑같이 다루면 안 되더라
핵심 원칙: 바로 개발시키지 않는다
처음에는 기획서를 주고 곧바로 구현을 맡기면 될 줄 알았다. 하지만 실무는 그렇게 단순하지 않다. 기획서에는 명확한 요구사항도 있지만, 기존 시스템과 연결했을 때 다시 확인해야 하는 정책, 영향 범위, 예외 케이스가 훨씬 많다.
그래서 Agent를 코딩에 바로 투입하는 대신, 작업을 단계로 쪼갰다.
1. as-is 명세 작성 — 현행 시스템의 사실을 먼저 문서로 고정
2. 기획서 분석 → "무엇을 왜 바꾸는가" to-be 변경 개요 작성
3. to-be 설계 — 변경 대상을 기능/섹터 단위로 쪼개 확정 (+ 설계 대안 비교)
4. 설계 문서 검토 후 확정
5. 작업을 파일 단위 백로그(BL-xx)로 분해
6. 검토 완료 후 개발 실행
7. 개발 Agent가 리뷰용 요약 생성 → 다른 Agent로 교차검토
8. 백로그 기준 코드 리뷰 및 개발자 테스트
9. 형상관리 시스템 push
이 흐름을 한 줄로 줄이면 이렇다: 먼저 사실(as-is)을 적고 → 변경 의도(to-be)를 설계로 확정하고 → 파일 단위 작업표(백로그)로 쪼개고 → 다른 AI로 문서 정합성을 교차검토한 뒤 → 코드에 반영한다. 코드보다 문서가 먼저 확정된다.
(1) as-is 명세 — 손대기 전에 현행을 고정한다
레거시 시스템은 동작 방식이 코드 곳곳에 흩어져 있거나 사람 머릿속에만 있다. 이 상태로 Agent에게 변경을 맡기면, 현행을 잘못 가정한 채 설계를 시작한다. 그래서 손대기 전에 현재 시스템의 사실부터 한 장으로 고정한다 — 기능 정의, 구성도, API 일람, 핵심 테이블과 식별자.
(아래 예시는 모두 가상 기능 — 외부 채널 상품의 즉시할인/쿠폰 관리를 레거시 어드민에 추가하는 시나리오로, 실제 식별자는 전부 치환했다.)
# 외부 채널 상품 즉시할인 — 개요 (현행/as-is)

## 1. 기능 정의
외부 채널(CH01) 연동 상품에 즉시할인/예약할인을 등록·수정·삭제·조회한다.

## 2. 시스템 구성도
| 계층       | 구성요소                        |
|------------|---------------------------------|
| 화면       | ScreenDiscountList              |
| 컨트롤러    | DiscountController              |
| 서비스/DAO | DiscountService / DiscountDao    |
| 핵심 테이블 | CHANNEL_PROD_DISCOUNT           |

## 3. API 일람   ## 4. 핵심 식별자   ## 5. 관련 문서 ...
as-is는 “바꿀 것”이 아니라 “이미 그런 것”을 적는 문서다. 이게 있어야 to-be 설계가 허공이 아니라 현실 위에 선다.
(2) to-be 설계 — 변경 의도를 문서로 확정한다
as-is가 고정되면, 기획서를 Agent에게 주고 플랜 모드에서 분석하게 한다. 이때도 바로 구현하지 않고, 먼저 “무엇을 왜 바꾸는가”를 변경 개요로 남긴다. 변경 개요에는 다음을 정리한다.
- 기능의 목적
- 주요 변경 사항
- 기존 기능과의 관계
- 확인이 필요한 정책
- 예상되는 영향 범위
변경 개요 문서는 이렇게 생겼다.
# TO-BE 구현 개요
> 출처 기획서: 정책.md, 목록-변경.md, 엑셀-변경.md, 쿠폰팝업.md
> 대상(as-is): /channel/CH01/product/discount/*

## 1. 변경 요지
| # | 변경                | 핵심                               |
|---|---------------------|------------------------------------|
| A | 쿠폰 기능 신규       | 상품 : 쿠폰 = 1:N (할인율 + 적용기간) |
| B | 검색조건 개편        | 할인단위 제거, 브랜드/쿠폰기간 추가    |
| C | 브랜드 선택 팝업      | 공통 소스 수정 불가 → 전용 신규 팝업   |
| D | 목록/수정/삭제/엑셀   | 쿠폰 컬럼, soft-delete              |

## 4. 횡단 영향 (as-is 대비)   ## 5. 영향 파일(예상)
- 쿠폰 1:N → 기존 1행 테이블로 표현 불가 → 신규 쿠폰 테이블 필요
- 최종 할인가 = 적용가 × (1 - 쿠폰율), 합산 판매자할인율 ≤ 90%
포인트는 “무엇을 왜 바꾸는가”를 변경 요지 표로 압축하고, 손대기 전에 횡단 영향과 영향 파일을 미리 식별한다는 것이다.
변경 개요가 확정되면, 그걸 기준으로 변경 대상을 쪼개 섹터별 설계 문서로 확정한다. 여기서 한 가지 선택이 있다 — 변경 대상을 API / UI / Data 같은 레이어로 나눌 수도 있고, 기능/섹터 단위로 나눌 수도 있다. 나는 후자가 변경 추적에 더 맞았다. “검색영역”, “브랜드 팝업”, “목록+쿠폰”, “데이터 모델”, “엑셀 업로드”처럼 기획서의 변경 단위와 1:1로 떨어지기 때문이다. 화면·API·데이터 영향은 각 섹터 문서 안에서 함께 적는다.
각 섹터 문서에는 개발 전에 확정해야 할 것도 같이 뽑아둔다.
- 개발 백로그
- 개발 중 예상되는 이슈
- 확정이 필요한 정책
- 테스트 대상
- 사이드 이펙트 가능성이 있는 부분
변경 대상을 정리하다 보면, 단순히 “어디를 고친다”가 아니라 “어떻게 설계할지를 결정해야 하는” 지점이 나온다. 이런 건 결정과 근거를 문서로 남긴다. 예를 들어 쿠폰을 저장할 구조를 정할 때, 대안을 비교하고 채택 이유를 적어둔 문서는 이렇게 생겼다.
# 쿠폰 데이터 모델 (설계)

## 1. 요구 제약 (기획 문구에서 도출)
| 제약                 | 출처 문구                  |
|----------------------|----------------------------|
| 상품 : 쿠폰 = 1:N     | "상품 1개당 무한 설정 가능"  |
| 중복 기간 시 최신 우선 | "마지막 등록 쿠폰 기준"      |
| 삭제는 soft-delete    | "사용여부 N으로 변경"        |

## 2. 저장 구조 — 대안 비교
| 안       | 구조                         | 장점        | 단점                    |
|----------|------------------------------|-------------|-------------------------|
| A (채택) | 기존 할인 유지 + 쿠폰 신규 1:N | 책임 분리   | 목록 조인 복잡          |
| B        | 기존 테이블을 1:N로 전환      | 테이블 재사용 | PK/스키마 대수술, 마이그레이션 |
| C        | 통합 1:N 테이블(종류로 구분)   | 일관성      | as-is 대거 변경         |
판단 기준: 기본/예약이 '현재값' 성격이면 A, '기간/이력/다건'이면 C.
이게 명세 기반 개발 흐름에서 가장 “설계다운” 산출물이다. 나중에 “왜 이렇게 했지?”가 나올 때, 채택 근거와 버린 대안이 같이 남아 있어 재논의 비용이 크게 준다.
(3) 구현 및 리뷰 단계
to-be 설계 문서를 내가 직접 검토하고, 문제가 없다고 판단되면 그때 개발을 실행한다. Agent의 설계를 그대로 믿고 들어가지 않고, 사람의 검토 단계를 반드시 한 번 끼운다.
개발이 끝나면 Agent가 만든 백로그 파일을 기준으로 코드 리뷰와 개발자 테스트를 한다. 어떤 요구사항이 반영됐는지, 어떤 파일이 바뀌었는지, 뭘 테스트해야 하는지를 백로그 기준으로 다시 확인한다.
이 방식의 장점: 작업 흐름이 눈에 보인다
Agent가 어떤 판단을 했는지, 어떤 파일을 변경 대상으로 봤는지, 어떤 이슈를 예상했는지가 전부 md로 남는다. 그래서 문제가 생겨도 단계별로 추적할 수 있다.
- 기획서 해석이 문제였나
- 설계는 맞았는데 변경 대상 식별이 틀렸나
- 구현 과정에서 깨졌나
사람과 Agent의 역할
이 방식의 핵심은 “AI가 다 한다”가 아니다. Agent가 산출물을 만들고, 사람이 게이트를 잡는다. 단계마다 역할이 갈린다.
| 단계 | Agent 역할 | 사람 역할 |
|---|---|---|
| as-is 작성 | 코드/문서 기반 현행 정리 | 사실 여부 확인 |
| to-be 설계 | 변경 개요와 영향 범위 도출 | 정책/방향 확정 |
| 백로그 분해 | 파일 단위 작업 항목 생성 | 작업 범위 승인 |
| 구현 | 코드 수정 및 리뷰용 요약 생성 | 위험 변경 확인 |
| 리뷰 | 누락/모순/회귀 위험 지적 | 최종 판단 및 테스트 |
1부 정리
여기까지가 단일 Agent를 안정적으로 쓰기 위한 기본 흐름이다. 정리하면, Agent에게 바로 구현을 맡기지 않고 다음 순서로 제한한다.
- 현행을 문서로 고정한다.
- 변경 의도를 문서화한다.
- 설계 대안을 비교하고 확정한다.
- 백로그로 작업 상태를 남긴다.
- 그 백로그를 기준으로 구현과 리뷰를 진행한다.
이 단계만으로도 꽤 안정적으로 운영할 수 있다. 그런데 4번의 백로그는 단순한 작업 목록이 아니다. 이 글에서 가장 강조하고 싶은 부분이라 2부에서 따로 다룬다. 그다음, 작업 규모가 커지면 생기는 검토 부담과 순차 진행의 한계는 3부에서 멀티 에이전트로 푼다.
2부. 백로그는 체크리스트가 아니라 세션 밖 상태다
백로그를 단순한 “할 일 체크리스트”로 생각하면 그 가치를 절반밖에 못 쓴다. 백로그의 진짜 힘은 세션 밖에 저장된 상태(state)라는 데 있다.
Agent 세션은 휘발성이다. 컨텍스트가 세션 안에만 살아 있어서, 세션이 끊기면 “지금까지 뭘 했는지”가 통째로 날아간다. 그런데 디스크에 남은 백로그 md는 세션이 죽어도 살아남는다.
실제로 구현 도중 컴퓨터가 다운돼서 세션이 통째로 날아간 적이 있는데, 새 세션에 백로그를 읽히는 것만으로 이어서 작업할 수 있었다. 그 일과 백로그를 어떻게 쓰는지는 다음 글에서 자세히 다룬다.
정리하면 백로그가 있을 때의 장점은:
- 세션 복구가 된다. 크래시·재시작·다음 날 이어 하기 — 어떤 이유로 세션이 끊겨도, 백로그를 읽히면 중단 지점에서 재개된다. AI 작업의 가장 큰 약점(세션 휘발성)을 디스크에 박아 둔 파일 하나로 메운다.
- 재개 비용이 크게 줄어든다. 새 세션에 컨텍스트를 다시 주입하거나 “지난번에 뭐 했는지” 길게 설명하는 비용이 크게 준다. (백로그를 읽히고 상태를 확인하는 비용은 남지만, 처음부터 다시 쌓는 것과는 비교가 안 된다.)
- 진행 상황이 그대로 보인다. 무엇이 끝났고, 무엇이 남았고, 무엇을 테스트해야 하는지가 한 파일에 정리돼 있다.
- 리뷰·인수인계의 기준이 된다. 리뷰를 맡는 다른 Agent도, 나중의 나도, 다른 동료도 이 파일 하나로 “지시받은 것 대비 실제로 한 것”을 대조할 수 있다.
즉 백로그는 작업 기록이자 작업 상태다. 사람의 메모이기 전에, 세션을 넘나드는 영속 메모리에 가깝다.
내 경우 백로그는 두 층이다. 전체를 ID로 집계하는 상위 백로그(BL-xx 상태 추적)와, 작업 파일 단위로 쪼갠 개별 백로그다. 개별 백로그에는 대상·변경 요지·초안·결정·확인 필요·잔여를 담는데, 특히 마지막 “잔여”가 세션이 끊겼을 때의 재개 지점 역할을 한다.
# BL-27 — 목록 조회 SQL 재작성

## 2. 변경 요지
| 구분        | as-is              | to-be                       |
|-------------|--------------------|-----------------------------|
| 기준 테이블  | 단일 할인 테이블    | 상품 기준 + 가격/할인 조인    |
| 라운딩      | ROUND(-1)          | TRUNC                       |
| 쿠폰        | 없음               | 유효·최신 1건                |

## 3. 초안 SQL (검토용)
SELECT P.PROD_CD, P.LIST_PRICE, CHG.PRICE AS BASE_APPLY_PRICE, ...
  FROM PRODUCT P
  INNER JOIN CHANNEL_PROD_LINK L ON ... AND L.CHANNEL_ID='CH01'
  LEFT JOIN ( /* 쿠폰 최신 1건: ROW_NUMBER() ... ORDER BY CP_SQ DESC */ ) CP ...

## 4. 결정      TRUNC 절삭 / 정률 고정 / universe = 채널 연동상품 INNER JOIN
## 5. 확인 필요  정렬 기준(보류), LIST_PRICE 0/NULL 방어
## 6. 진행      [x] 매퍼 반영   [ ] 빌드/런타임 검증   ← 재개 지점
세션이 날아가도, 새 세션에 이 파일 하나만 읽히면 “결정은 뭐였고, 어디까지 했고, 다음에 뭘 하면 되는지”가 그대로 복원된다. 그리고 같은 파일이 뒤에서 볼 리뷰의 기준도 된다.
3부. 멀티 에이전트 운영
1~2부의 단일 Agent 흐름만으로도 충분히 쓸 만하다. 하지만 작업 규모가 커지면 두 가지 한계가 생긴다.
- 검토가 사람 한 명에게 몰린다. as-is·설계·구현 결과를 전부 내가 눈으로 본다.
- 작업이 기본적으로 순차다. 설계 끝나면 구현, 구현 끝나면 리뷰.
첫 번째는 실제로 적용했다 — 구현과 리뷰를 다른 Agent로 분리하는 것. 두 번째, 독립적인 작업을 병렬로 굴리는 것은 아직 운영해보진 않았고 다음 단계로 보고 있다. 둘을 순서대로 적되, 어디까지가 실제 경험이고 어디부터가 구상인지는 구분해서 쓴다.
앞서 링크한 등급 분류로 보면, 이 3부는 Large 이상 작업의 얘기다. 별도 리뷰 세션을 두는 건 Large, 작업을 쪼개 병렬 Agent로 굴리는 건 Epic에 해당한다. 가벼운 작업엔 여기까지 갈 일이 없다.
executor / reviewer 분리
사람 검토를 없애자는 게 아니다. 사람 검토 앞에 기계적인 교차검토 단계를 하나 더 두는 것이다.
나는 구현 담당 Agent를 executor, 리뷰 담당 Agent를 reviewer로 나눴다.
- executor: 설계 문서를 받아 실제 코드를 구현하고, 리뷰용 요약을 만든다.
- reviewer: 구현 결과를 받아, 요구사항 누락·사이드 이펙트·계약 위반(인터페이스/응답 구조 변경)을 점검한다.
내 경우는 Claude Code를 executor로, Codex 계열 도구를 reviewer로 사용했다. 여기서 중요한 건 특정 도구 조합이 아니라, 구현한 주체와 리뷰하는 주체를 분리하는 것이다. 같은 세션이 자기 코드를 리뷰하면, 자기가 한 가정을 그대로 정답으로 깔고 보기 때문에 놓치는 게 생긴다.
reviewer는 막연히 “리뷰해줘”로 부르면 안 된다. 처음엔 개발이 끝난 뒤 그냥 “리뷰해줘”라고만 시켰는데, 전체 코드/문서를 통째로 스캔해버렸다. 결과는 둘 다 나빴다. 토큰 소모가 컸고, 리뷰 내용도 실제 변경 위험보다는 사소한 대안 제시나 범위 밖 지적이 많았다. 범위가 없으니 뭐가 중요한지 모르고 전부를 똑같이 의심한 것이다.
그래서 방식을 바꿨다. executor에게 백로그를 참고해 “리뷰용 요약”을 한 장 만들게 하고, reviewer는 전체 코드가 아니라 그 요약본을 기준으로 리뷰하게 했다. 리뷰용 요약은 새로 쓰는 문서가 아니라, 이미 쌓인 백로그에서 무엇을 바꿨고 어디를 봐야 하는지만 추려낸 파생 파일이다. 범위와 초점이 잡히니 토큰도 줄고, 코멘트도 실제 변경 지점에 대한 검토로 바뀌었다.
reviewer에게 우선적으로 보게 한 항목은 다음과 같았다.
- 설계 문서와 실제 diff가 일치하는가
- 확정된 정책을 코드가 위반하지 않는가
- API 요청/응답 계약이 깨지지 않았는가
- MyBatis mapper와 DAO 시그니처가 일치하는가
- null / empty / 0 같은 경계값 처리가 빠지지 않았는가
- 기존 화면, 엑셀 다운로드, 배치 등 우회 경로가 깨지지 않았는가
- 테스트해야 할 항목이 백로그에 남아 있는가
여기서 명세 기반 개발의 산출물이 그대로 리뷰 기준이 된다는 게 포인트다. 리뷰 입력이 없으면 reviewer는 “뭘 기준으로 볼지”가 없어서, 전체를 스캔하며 인상 비평만 한다. executor가 남긴 설계 문서·백로그·리뷰용 요약이 곧 “지시받은 것 대비 실제로 한 것”을 기계적으로 대조하는 기준이 된다.
리뷰 프롬프트 자체에도 범위를 박아둔다. 핵심은 “수정하지 말고 분석·지적만”, 그리고 “이미 확정된 결정은 재논의 금지”다. 확정 사항을 못 박아두지 않으면, reviewer가 끝난 논의를 다시 들쑤시며 “이건 이렇게 하는 게 낫지 않냐”는 식의 노이즈를 만든다.
# 교차검토 요청 프롬프트 — 설계 정합성

## 0. 역할/범위   설계 문서군의 정합성 검토. 수정 금지, 분석·지적만.
                  결과는 "근거 파일:라인 + 문제 + 제안" 형식.
## 2. 확정된 결정 (재논의 금지 / 위반 표현만 지적)
   1. 저장구조 = 안 A   2. 라운딩 = TRUNC   3. 정률 고정 ...
## 3. 우선 검토   문서 간 모순 / 끊긴 참조 / SQL 논리 / 누락 케이스 / 회귀 위험
받은 리뷰 결과도 같은 형식으로 정리해 반영 여부를 추적한다.
# 교차검토 결과
| # | 근거            | 현상              | 영향     | 제안          | 반영 |
|---|-----------------|-------------------|----------|---------------|------|
| 1 | 04 §3 / BL-27   | 컬럼명 표기 불일치 | 혼선     | 한쪽으로 통일  | ✅   |
| 2 | 05 §8           | 라운딩 잔존 표현   | 계산 오차 | TRUNC로 수정  | ✅   |
“근거 파일:라인 → 현상 → 영향 → 제안 → 반영” 형식이라, 리뷰가 감상이 아니라 추적 가능한 작업 항목이 된다.
worktree 병렬화 (아직 운영 전, 다음 단계)
여기서부터는 아직 실무에 적용해보지 않은, 다음 단계로 검토 중인 방향이다. 위(1~2부 흐름 + executor/reviewer 분리)까지가 실제로 굴려본 것이고, 이 절은 “이렇게 가려고 한다”는 구상이다.
executor/reviewer를 나눠도 작업은 기본적으로 순차다. 그런데 작업이 서로 독립적이라면, 굳이 순차로 할 이유가 없다. 여러 세션을 동시에 돌리면 된다. 문제는 같은 repo에서 여러 세션이 동시에 파일을 건드리면 충돌이 난다는 것이다.
그래서 검토하는 게 git worktree다. worktree는 같은 저장소의 브랜치를 별도 작업 디렉터리로 분리해주는 git 기본 기능이다. 각 Agent가 자기 worktree 안에서만 파일을 만지면 서로 밟지 않는다. 파일시스템 수준에서 격리가 된다.
구체적으로 worktree를 어떻게 만들고 각 세션에 붙이는지는 쓰는 도구마다 다르고, 나도 아직 실제로 돌려보지 않았다. 그래서 여기선 명령까지는 적지 않는다. 적용할 때는 사용하는 도구의 공식 문서를 확인하는 게 맞다.
다만 worktree가 모든 것을 격리해주지는 않는다. 파일은 작업 디렉터리 단위로 분리되지만, 로컬 DB, 테스트 데이터, 포트, 빌드 산출물, 캐시 같은 실행 환경은 별도로 격리되지 않을 수 있다. 병렬 세션을 실제로 운영하려면 코드 충돌뿐 아니라 실행 환경 충돌도 같이 봐야 한다.
어떤 축으로 쪼개나
가장 직관적인 건 API 세션 / UI 세션으로 나누는 것이다. 그 외에도:
- feature 단위 (서로 의존 없는 기능을 각 세션에)
- 마이그레이션 배치 단위
- research(조사) / implementation(구현) 분리
- 1 writer + read-only reviewer (구현은 한 세션만, 나머지는 읽기 전용 검토)
병렬화가 깨지는 지점
무조건 쪼갠다고 빨라지지 않는다. 세션 간에 공유하는 계약(contract)이 있으면 동시 수정 시 어긋난다.
대표적인 게 MyBatis다. DAO 인터페이스와 mapper.xml은 메서드 시그니처·파라미터·resultType으로 강하게 묶여 있다. 한 세션이 DAO를 고치고 다른 세션이 같은 영역의 mapper.xml을 고치면, 둘 다 “맞게” 작업해도 합쳤을 때 계약이 어긋날 수 있다(drift).
그래서 이런 경우엔 병렬화 전에 계약부터 고정(contract-first) 한다.
- 먼저 DAO 인터페이스·요청/응답 DTO 구조를 확정해서 박아두고
- 그게 변하지 않는다는 전제 위에서 세션을 나눈다.
계약을 못 고정하겠으면, 차라리 그 부분은 순차로 하거나 1 writer 구조로 가는 게 낫다. “병렬로 쪼갰는데 합칠 때마다 충돌나서 더 느려지는” 함정을 피해야 한다.
의존성 처리는 특히 조심. 예를 들어 한 세션이 만든 DTO 필드를 다른 세션이 화면/응답에 매핑해야 한다면, 뒤쪽 세션은 앞쪽의 필드명을 알아야 한다. 이런 의존이 있으면 “병렬”이 아니라 “순서가 있는 작업”이다. 분해 단계에서 이걸 먼저 가려내야 한다.
정리
내가 쓰는 방식은 Agent에게 코드를 맡기는 게 아니다.
Agent가 먼저 현행을 정리하고 → 변경 의도를 설계로 남기고 → 백로그로 상태를 기록하고 → 다른 Agent가 교차검토하고 → 사람이 검토·승인한 뒤 구현하는 절차다. executor와 reviewer를 분리하는 데까지가 지금 실제로 굴리고 있는 단계이고, 독립적인 작업을 worktree로 격리해 병렬로 굴리는 건 다음 단계로 보고 있다. 그때도 원칙은 같다 — 계약이 묶인 곳은 먼저 고정하거나 순차로 간다.
핵심을 다시 적으면:
- Agent의 속도를 실무에서 쓸 수 있는 안정성으로 바꾸는 건 프롬프트가 아니라 절차다.
- 모든 판단을 md 산출물로 남기면, 문제 추적과 교차검토가 동시에 쉬워진다.
- 백로그는 체크리스트가 아니라 세션 밖에 저장된 상태다. 세션이 죽어도 중단 지점에서 재개할 수 있게 해준다.
- 핵심은 “AI가 다 한다”가 아니라, Agent가 산출물을 만들고 사람이 게이트를 잡는 구조다.
- 병렬화로 넘어갈 때는 “독립적인가”를 먼저 따진다. 계약이 묶인 걸 억지로 쪼개면 오히려 느려진다.
Agent는 빠르게 망하는 길도, 안정적으로 빨라지는 길도 똑같이 잘 간다. 어느 쪽으로 가게 만들지는 결국 절차가 정한다.