다시 실험하려고 실험장부터 만들었다
2026.10.06 게시
이 시리즈는 작성 시점의 기록이다. 현재 기준은 Adaptive Agentic SDD 저장소에 정리해두었다.
이후 변경 · 이 글의 진단 과제 판정은 16편에서 검사별로 다시 봤다. 취소·재시도 실패는 실패라고 보기 어렵거나 요구사항을 어떻게 읽느냐에 따라 달라졌고, 확실하게 남은 건 A의 예외 하나다. 본문은 그때 기록으로 그대로 둔다.
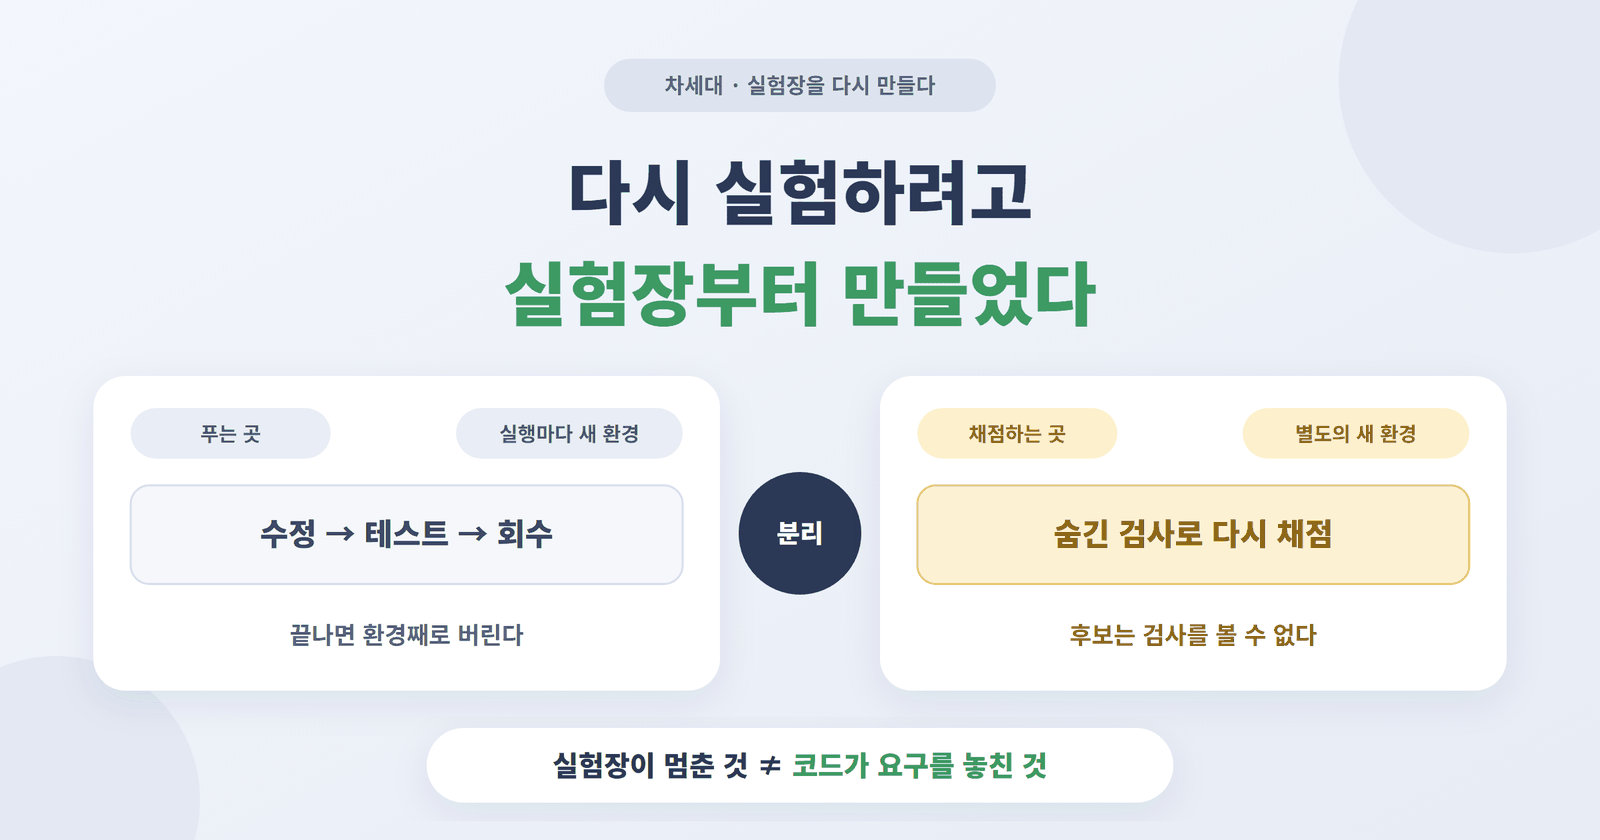
지난 글의 실험은 모델을 비교하기도 전에 멈췄다.
한 번은 작업에 필요한 도구까지 막았다. 다른 한 번은 다음 후보가 앞 후보의 파일을 읽을 수 있었다.
못해도 모델 때문인지 모르고, 잘해도 혼자 푼 건지 모르는 상태였다.
지난 글 끝에서 격리를 더 단단하게 만들지, 정답 코드가 옆에 없어도 되는 과제로 바꿀지 못 정했다고 썼다. 단단하게 만드는 쪽으로 갔다. 다음에는 방법론 연결을 만든 이야기를 하겠다고도 했는데, 그 전에 이 이야기부터 적는다.
다시 돌리려면 실험장부터 바꿔야 했다.
실행할 때마다 새 방을 만들었다
앞선 방식은 같은 컴퓨터에서 폴더별 접근 권한을 조절했다. 그런데 실제로 파일을 만든 뒤에는 권한 상태가 달라졌다.
이번에는 Windows Sandbox로 실행마다 새 환경을 만들었다.
14편에서 말한 샌드박스와는 다른 것이다. 그때는 Codex CLI가 명령에 거는 권한 제한이었다. 이번 것은 Windows에 들어 있는 일회용 가상 환경이고, 닫으면 안에서 만든 것이 남지 않는다고 되어 있다(Microsoft 문서).
새 환경이라는 이름만 믿지는 않았다. 첫 환경에서 파일을 만든 뒤 종료하고, 다음 환경에 그 파일이 없는지 직접 확인했다.
종료할 때 연결 프로세스가 남는 문제도 있었다. 창이 닫혔다고 끝난 게 아니었다.
푸는 곳과 채점하는 곳도 나눴다
후속 과제는 실제로 끝난 개발 작업에서 골랐다. 당시 요구사항과 구현 전 소스를 복원했다.
해결 코드와 이후 리뷰는 빼고, Git 이력도 전달하지 않았다.
| 후보에게 주는 것 | 따로 보관하는 것 |
|---|---|
| 당시 요구사항·초기 소스 | 해결 코드·이후 리뷰 |
| 필요한 도구·의존성 | 앞 후보의 결과 |
| 기존 테스트·공통 규칙 | 숨긴 판정용 검사 |
13편에서는 완료 조건과 검사를 후보에게 그대로 줬고, 그게 체크리스트 노릇을 했을 수 있다고 적었다. 이번에는 판정용 검사를 후보에게 보여주지 않는다.
작업이 끝나면 허용된 소스만 회수해서 별도의 새 환경에서 다시 채점했다.
후보가 “통과했다”고 말하는 것과, 회수한 코드가 실제로 통과하는 것을 구분하려고 했다.
모델 연결은 밖에, 작업 도구는 안에
작업 환경의 외부 통신은 제한하려는데, 모델을 부르려면 인터넷이 필요했다.
그래서 둘을 나눴다.
모델 자체를 Sandbox 안에 넣은 것은 아니다. 모델이 사용하는 작업 도구를 그 안에서 실행하게 했다.
호스트의 인증 정보나 정답을 후보에게 넘기지는 않았다. 보호된 파일 읽기가 거부되는지, 시간 초과 뒤 프로세스가 정리되는지도 확인했다.
외부 연결도 후보 쪽 계정에서 실제로 거부되는지 확인했다. 모든 우회 경로를 막았다는 뜻은 아니다. 직접 연결해봤을 때 막혔다는 것까지다.
다시 부르기 전에 끝까지 돌려봤다
환경이 뜨고, 명령이 실행되고, 채점기가 돌아가면 준비가 된 줄 알았다. 그래서 실제 모델을 불렀다.
첫 쌍은 각각 2분쯤 만에 끝났다. 모델이 그 환경에 없는 명령을 호출하자 실행기가 오류를 돌려주지 못하고 끊겼다.
고치고 나서 한 쌍을 더 불렀다. 이번에는 둘 다 파일을 살펴보던 중에 연결이 끊겼다. 원인으로 보이는 것을 하나 재현해서 고쳤지만, 그게 실제 원인이었는지는 확정하지 못했다.
네 번 모두 코드를 고치는 데까지도 가지 못했다.
부품별로 되는 것과 전체가 이어지는 것은 달랐다.
그래서 다시 부르기 전에, 모델 대신 미리 정한 동작으로 수정 → 테스트 → 회수 → 별도 채점 → 종료까지 리허설했다.
| 미리 넣은 코드 | 후보 쪽 테스트 | 별도 채점 |
|---|---|---|
| 수정 전 코드 | 15개 통과 | 255개 중 예상한 2개 실패 |
| 준비한 정답 코드 | 15개 통과 | 255개·lint·빌드 통과 |
기존 테스트는 양쪽 다 통과했다. 요구를 확인하는 별도 검사에서 차이가 났다.
별도 채점의 255개에는 후보에게 보여주지 않은 판정용 검사 5개가 들어 있다. 수정 전 코드가 떨어진 2개가 그 안에 있다.
두 대조 모두 회수와 종료까지 끝났다. 모델 호출은 없었다.
확인한 것은 모델의 실력이 아니라 실험장의 동작이었다.
실제 모델을 넣고 돌려봤다
리허설 뒤에는 실제 모델로 돌렸다. 리허설을 통과했다고 바로 끝까지 가지는 않았다.
| 실제 호출 | 어디까지 갔나 |
|---|---|
| 1~2번째 | 없는 명령을 호출하자 실행기가 끊김. 수정 전에 종료 |
| 3~4번째 | 파일을 살펴보던 중 연결이 끊김. 수정 전에 종료 |
| (리허설) | 모델 호출 없이 끝까지 통과 |
| 5번째 | 모델 작업 시간이 마감에 다다르자 수정본을 회수하지 못하고 실패. 짝이 되는 B는 부르지 않음 |
| 6~7번째 | A는 빌드 도구가 남긴 빈 파일 하나 때문에 회수 범위 검사에서 거부되어 채점하지 못함. B는 채점까지 가서 통과 |
| 8~9번째 | 양쪽 다 회수·채점·종료 완료 |
| 10~11번째 | 양쪽 다 회수·채점·종료 완료 |
실제 호출은 모두 11번이다. 앞의 7번에서는 비교할 수 있는 쌍이 하나도 나오지 않았다. 7번째의 B 하나만 채점을 통과했고, 나머지 여섯 번은 모델이 못해서가 아니라 실험장 쪽에서 걸렸다.
5번째가 걸린 곳은 리허설이 지나가지 않은 길이었다. 리허설에서는 미리 정한 동작이 마감 전에 끝났다. 실제 모델은 마감까지 일했고, 마감에 걸린 상태에서 수정본을 회수하는 길은 돌려본 적이 없었다.
14편에서 적은 것과 같은 모양이다. 검사한 상태와 실제로 쓰는 상태가 달랐다.
6번째의 A는 나중에 그 빈 파일만 빼고 따로 채점해봤고, 통과했다. 그래도 원래 결과는 “채점하지 못함”으로 그대로 뒀다.
호출은 쌍마다 두 번씩만 열었다. 실패해도 그 두 번에서 빼고, 같은 쌍을 다시 부르지 않았다. 다만 13·14편처럼 전체 횟수를 처음에 정해두고 지킨 것은 아니다. 실험장을 고칠 때마다 다음 쌍을 새로 열었다.
그래서 앞의 일곱 번은 하네스의 보조 절차 비교가 아니라 실행기를 맞추는 과정으로 적는다.
모델은 GPT-6.1 Sol, 추론 수준은 xhigh였다. A와 B의 차이는 13편과 같다.
| A | B |
|---|---|
| 수정 전에 순서 있는 변경 목록을 작성하도록 요구 | 목록 작성을 요구하지 않음 |
B에게 계획하지 말라고 하지는 않았다. 실제로 B도 수정 방향을 짧게 설명했다. 비교하려는 것은 목록 작성을 의무로 두는 것이 결과를 바꾸는가였다.
나머지 조건은 13편과 다르다.
| 13편 | 이번 | |
|---|---|---|
| 모델 | GPT-5.6 Sol, medium | GPT-6.1 Sol, xhigh |
| 과제 | 실험용으로 새로 만든 작은 프로그램 | 실제로 끝난 개발 작업을 복원한 것 |
| 판정용 검사 | 후보에게 그대로 줌 | 후보에게 보여주지 않음 |
| 횟수와 순서 | 과제 하나에 두 쌍, A → B → B → A | 과제마다 한 쌍, A → B |
그래서 13편의 결과와 나란히 놓고 비교할 수는 없다.
끝까지 간 것은 두 과제에서 각각 한 쌍이다. 첫 번째는 실행기를 맞추는 데 쓴 교정 과제이고, 두 번째는 과거에 실제로 누락이 있었던 작업을 고른 진단 과제다.
| 실행기 교정용 과제 | 과거 누락을 확인하는 과제 | |
|---|---|---|
| 후보 하나에 준 전체 시간 | 20분 | 30분 |
| 그중 모델 작업 시간 | 7분 30초 | 14분 |
전체 시간에는 준비, 회수, 별도 채점, 종료가 다 들어간다.
두 번째 과제는 원래 방법론대로면 수정 전에 계획 문서를 쓰는 등급이다. 그걸 그대로 요구하면 B도 계획을 쓰게 되어 비교가 겹친다. 그래서 그 단계는 양쪽 다 뺐다. 이번 비교는 방법론 전체를 잰 것이 아니다.
두 번째 과제의 요구 중 하나는 당시 기록에서 근거를 찾지 못했다. 그건 이번에 정해서 양쪽에 똑같이 줬다.
숨긴 검사는 과제마다 5개다.
| 과제 | 수정 전 코드 | A의 숨긴 검사 | B의 숨긴 검사 | 판정 |
|---|---|---|---|---|
| 실행기 교정용 과제 | 5개 중 2개 실패 | 5개 모두 통과 | 5개 모두 통과 | 양쪽 요구 충족 |
| 과거 누락을 확인하는 과제 | 5개 중 1개 실패 | 5개 중 3개 실패 | 5개 중 2개 실패 | 양쪽 요구 미충족 |
두 번째 과제에서는 과거에 누락이 있었던 당시 구현도 같은 채점기에 넣어봤다. 5개 중 3개가 실패한다. 고치기 전보다 고친 뒤에 실패가 늘어날 수 있는 과제다. 새 동작을 넣으면서 실패하는 경로까지 챙겨야 통과한다.
모델 작업 시간은 두 과제 모두 정해둔 마감에 도달했다. 모델의 완료 선언을 받은 결과는 아니다. 마감 시점의 수정본을 회수해서 별도 환경에서 채점했다.
이번에는 실패한 이유를 나눌 수 있었다
두 번째 과제에서는 A가 실제로 변경 목록을 쓰고 작업했다. 그래도 예외·재시도·취소 경로의 결함이 남았다. B도 재시도·취소 경로를 놓쳤다.
A가 떨어진 세 검사는 과거의 당시 구현이 떨어지는 세 검사와 같다.
빌드와 정적 검사는 양쪽 다 통과했다. 요구를 확인하는 숨긴 검사에서 실패했다.
이번에는 실험장이 멈춘 것과, 회수한 코드가 요구를 놓친 것을 구분할 수 있었다.
구분한 것은 거기까지다. 왜 놓쳤는지까지 나눈 것은 아니다.
두 후보 모두 14분 마감에 걸렸다. A는 스스로 돌리던 전체 검사를 끝내지 못했다. 후보가 실행한 명령도 절반쯤 실패했다. A는 17개 중 8개, B는 16개 중 9개이고 대부분 출력 길이 한도에 걸린 것이다.
시간이 더 있었거나 명령이 덜 막혔다면 결과가 달랐을지는 모른다. 실험장이 멈추지는 않았지만, 실험장의 조건이 결과에 섞였을 가능성은 남아 있다.
판정표는 결과를 보기 전에 적어둔 것이 있었다.
| 한 쌍의 결과 | 미리 적어둔 판정 |
|---|---|
| 양쪽 충족 | 차이를 못 본 것. 같다고 확인한 건 아님 |
| 양쪽 미충족 | 이 절차가 도움이 됐다는 근거는 아님. 요구·환경·과제 크기·절차가 맞는지 다시 볼 것 |
두 과제의 결과가 각각 이 두 줄에 해당한다. 다만 이 판정표는 검토 중이던 평가 계획 초안에 있던 것이고, 그 계획 전체를 정식으로 채택한 것은 아니다.
그렇다고 B가 더 좋다는 결론은 아니다. 과제마다 한 번씩이고 순서도 A 다음 B로 고정이었다. 두 번째는 과거에 누락이 있었던 작업을 일부러 골랐다. 실패 개수 하나의 차이로 목록 작성이 오히려 방해했다고 말할 수는 없다.
지금까지 확인한 것은 이 정도다.
| 확인한 것 | 아직 모르는 것 |
|---|---|
| 실제 모델의 수정본을 회수하고 별도로 채점했다 | 보조 절차를 빼도 되는가 |
| 교정 과제에서는 양쪽 다 통과했다 | 다른 작업에서도 같은가 |
| 진단 과제에서는 목록을 쓴 쪽도 요구를 놓쳤다 | 어떤 보조가 이 누락을 줄이는가 |
| 끝까지 간 두 쌍에서는 실험장이 멈추지 않았다 | 마감과 명령 한도가 결과에 얼마나 섞였는가 |
이 보조 절차를 빼도 된다는 답은 여전히 못 얻었다.
이 실험장으로 이어서 돌릴 계획은 아직 잡지 않았다. 열어둔 호출은 다 썼다. 다음에 잰다면 아직 쓰지 않은 다른 작업과 새 한도를 먼저 정해야 한다.
대신 질문은 조금 구체적이 됐다. 목록을 썼는지 확인하는 데서 끝낼 수는 없었다. 그 목록이 막으려던 누락을 실제로 막았는지까지 봐야 했다.
실험장을 다시 만든 이유도 결국 그 차이를 보기 위해서였다.
관련 글과 참고 자료: