Agent 방법론 자기개선 과연 잘 될까?
2026.10.16 게시
이 시리즈는 작성 시점의 기록이다. 현재 기준은 Adaptive Agentic SDD 저장소에 정리해두었다.
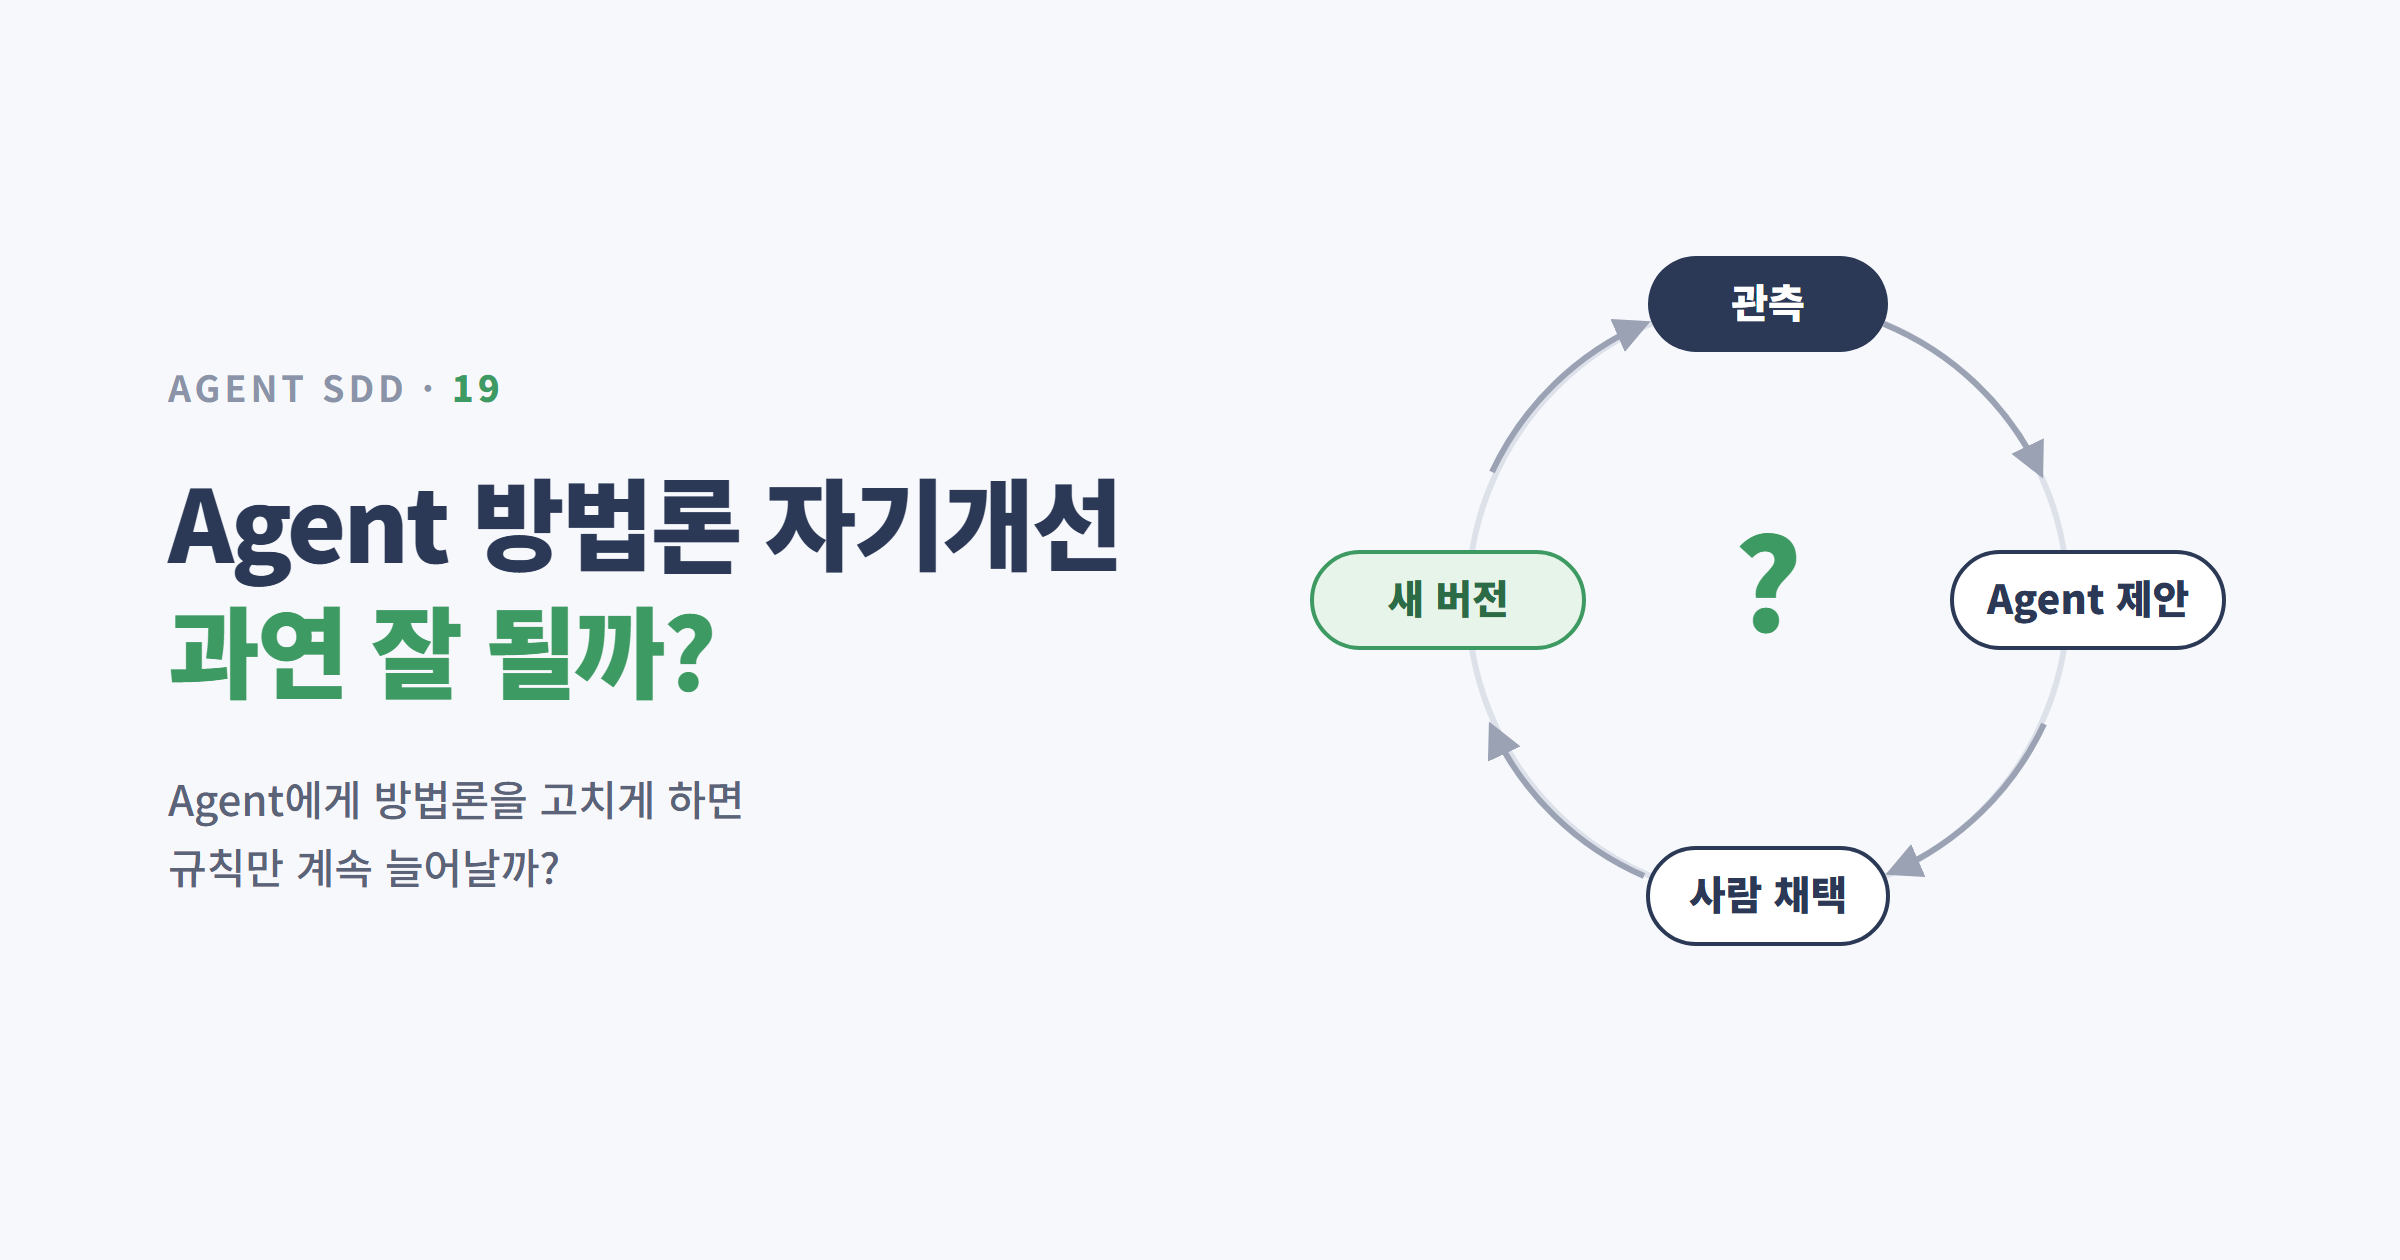
17편 처음에 방향을 두 개 잡았다. 기계가 판단할 수 있는 건 기계에 넘기고, Agent가 고칠 수 있는 건 Agent가 스스로 고치게 한다. 17편은 첫 번째 얘기였고, 이번이 두 번째 얘기다.
기대한 그림은 이랬다. Agent가 작업하면서 누락이나 재작업을 보면, 그걸 근거로 방법론을 이렇게 고치자고 제안한다. 나는 받아들일지만 정한다. 그러면 사고가 날 때마다 내가 규칙을 하나씩 덧붙이던 일에서 조금은 벗어날 수 있을 것 같았다.
지난 글에서 차세대 규칙이 실제로 읽히는 곳은 작업의 시작·인계·종료 기록뿐이라고 했다. 그러니 개선의 재료도 거기서 나와야 한다.
해 보니 생각한 것과 꽤 달랐다.
먼저 경계부터
17편 끝에서 정한 경계를 다시 적어 둔다. Agent에게 방법론을 고치게 하면, Agent가 자기를 묶는 규칙을 스스로 풀 수도 있기 때문이다.
| Agent가 제안할 수 있는 것 | 사람이 확정하는 것 |
|---|---|
| 설명 문구, 예시, 읽기 안내 | 단계 추가·삭제, 승인 방식, 실행 권한 |
| 템플릿에서 결정 항목이 아닌 부분 | 금지·필수 문장, 점검 항목 삭제 |
두 가지를 더 정했다.
- 사고 하나로 바로 영구 규칙을 만들지 않는다. 먼저 사례로 남긴다.
- 규칙을 더할 때는 “이 규칙이 필요 없어졌다고 볼 상황”도 같이 적는다.
17편에서 본 “사고 → 규칙 추가 → 문서가 길어짐 → 또 놓침”을 개선 과정에서 다시 만들지 않으려는 장치다.
고치려고 보니 근거가 없었다 (10/10)
먼저 지난 작업 기록을 모아서 개선 근거로 써 보려고 했다. 그런데 쓸 수 있는 게 없었다.
기록이 없었던 건 아니다. 이슈 댓글도, 작업 요약도 많았다. 문제는 그 기록에서 “이 작업에 차세대 규칙이 적용됐는지”조차 가릴 수 없었다는 거다. 어떤 기준으로 시작했는지, 끝날 때 무엇을 확인했고 무엇을 못 했는지가 작업마다 제각각이었다.
따라가 보니 Agent가 시킨 걸 안 한 게 아니었다. 애초에 누가, 언제, 무엇을 남기고, 다음 작업이 그걸 어떻게 다시 찾는지 정한 문장이 없었다. Agent의 실수가 아니라 내 규칙의 빈칸이었다.
그래서 공통 규칙 문서 두 개에 관측 계약을 넣었다. 작업마다 무엇을 기록으로 남길지 정한 약속이다.
| 언제 | 남기는 것 |
|---|---|
| 시작할 때 | 무엇을 기준으로 삼았는지, 어떤 버전의 규칙을 읽었는지 |
| 넘겨줄 때 | 받는 쪽이 다시 찾을 수 있는 원본 위치 |
| 끝날 때 | 무엇을 봤고 무엇을 못 봤는지, 그게 어디서 나온 정보인지 |
| 끝날 때 | 다음 판단: 이번에 쓴 규칙을 유지할지, 조정할지, 따로 바꿀지, 판단할 자료가 부족한지 |
자동 수집기나 Hook, 새 승인 단계는 넣지 않았다. 17편에서 효과를 보기 전에 장치부터 키우지 않기로 했으니까. 이미 작업 끝에 쓰던 요약에 몇 줄 더 붙이는 정도다.
첫 한 바퀴 (10/11)
기록이 쌓이기 시작하고 다음 날, 실제로 한 바퀴를 돌려 봤다.
실제 작업에서 나온 관측 4개를 근거로 Agent가 개선안 두 개를 냈다.
첫째, 요구와 검증을 잇자. 같은 요구가 여러 진입점에 적용돼야 하는데 그중 한 곳을 놓친 작업이 있었다. 코드를 고치기 전에 쓰는 변경 목록에 “이 요구는 어디에 적용되고, 무엇으로 확인하는지”를 한 줄씩 붙이자는 제안이었다.
둘째, 같은 말을 두 번 쓰지 말자. 시작 기록과 종료 기록에 같은 버전, 같은 사유가 반복해서 적히고 있었다. 종료 기록은 시작 기록을 가리키고, 그 사이 새로 바뀐 것만 적자는 제안이었다.
둘 다 받아들였다. 공통 문서를 고치고 검사를 돌리고 새 버전을 만들었다. 앱이 그 새 버전을 골라 읽는 것까지 기록으로 확인했다.
마음에 든 건 둘 다 새 문서도, 새 단계도, 새 도구도 아니었다는 점이다. 하나는 이미 있는 목록에 한 줄을 붙이는 거였고, 다른 하나는 오히려 덜 쓰게 하는 거였다.
다만 이건 한 사례다. 이 변경으로 누락이나 기록 비용이 실제로 줄었는지는 아직 재지 않았다.
사흘 뒤 감사 (10/13)
며칠 사이 처리한 작업이 많아져서, 기록이 정말 그렇게 남고 있는지 확인했다. 관측 계약을 붙인 뒤 병합된 작업 33건 중 10건을 골라 기록을 대조했다. 골고루 뽑은 게 아니라 확인하고 싶은 걸 골랐다.
좋은 소식부터. 앞 작업의 종료 기록이 다음 작업의 시작 판단에 실제로 쓰인 사례가 나왔다. 10월 10일엔 “다음 작업이 이걸 읽는지”를 아직 못 봤는데, 그게 처음으로 이어졌다.
나쁜 소식도 있었다. 종료 기록 3건에는 다음 판단이 없었다. 다시 조회했다고 적었는데 어느 판본을 봤는지 알 수 없는 기록도 있었다.
왜 빠졌는지는 정하지 못했다. 규칙이 모호했을 수도, Agent가 놓쳤을 수도, 참조만 남기다 정보가 빠졌을 수도 있다. 원인을 모르는 채로 새 의무를 붙이면 17편에서 본 그 반복이 된다. 그래서 해당 기록만 보정하고 규칙은 그대로 뒀다.
정기 점검을 원했는데 (10/14)
감사를 하고 나니 욕심이 생겼다. 이런 대조를 매번 내가 시킬 수는 없으니, 정기 배치로 돌리면서 Agent가 쌓인 기록을 분석하고 개선 후보를 이슈로 만들어 주면 좋겠다고 생각했다.
검토해 보니 두 군데에서 걸렸다.
| 처음 원한 것 | 바꾼 것 | 이유 |
|---|---|---|
| 정기 배치 | 사람이 원할 때 실행하는 Skill | 특정 저장소 호스트의 예약 기능에 묶이면 다른 프로젝트로 못 옮긴다 |
| Agent가 분석하고 이슈까지 생성 | 분석하는 쪽에는 쓰기 도구를 주지 않음 | 지시 주입이 그대로 행동이 될 수 있다 |
첫 번째는 18편과 같은 얘기다. 방법론을 프로젝트 밖으로 빼 놓고, 점검을 특정 호스트 기능에 다시 묶으면 의미가 없다.
두 번째가 더 중요했다. 분석 대상인 기록은 Agent가 쓴 거다. 그 안에 엉뚱한 지시 문장이 섞여 들어갈 수도 있다. 그걸 읽는 Agent가 저장소 접근 권한과 이슈를 쓰는 권한까지 갖고 있으면, 기록 속 문장 하나가 사람 없이 실제 행동으로 이어질 수 있다.
Simon Willison이 lethal trifecta라고 부른 조합이 딱 이거다. 믿을 수 없는 입력을 읽고, 비공개 데이터에 접근하고, 밖으로 무언가를 내보낼 수 있는 Agent. OWASP LLM01도 대응으로 최소 권한과 위험한 행동에 대한 사람 승인을 든다.
검토를 거치면서 순서도 바꿨다. 도구부터 만들지 말고, 감사 표본 10건에 손으로 먼저 해 보기로 했다. 결과적으로 이게 맞았다.
손으로 먼저 해 보니 (10/14)
10건에 점검 항목 네 개를 손으로 적용했다.
| 점검 항목 | 10건 결과 |
|---|---|
| 시작 기록 원본이 있나 | 모두 있음 |
| 다음 판단이 있나 | 3건 누락 |
| 다시 조회한 판본을 알 수 있나 | 4건 누락 |
| 이전 관측을 참조했나 | 2건 누락, 2건 애매 |
그다음 같은 판정을 기계적인 규칙으로 바꿔 봤더니 손 판정과 거의 맞았다. 그런데 이건 자랑할 게 아니다. 같은 10건을 보면서 만든 규칙이니 맞는 게 당연하다. 오히려 눈에 띈 건 기록 형식이 너무 제각각이라는 점이었다. 시작 기록을 표시하는 방식만 다섯 가지였고, 한국어와 영어, 시각 형식도 섞여 있었다.
그리고 더 중요한 걸 하나 발견했다. 점검을 언제 돌려야 하느냐였다.
처음엔 PR을 만들 때 기록을 점검해서 알려 주는 Hook을 생각했다. 그런데 10건 중 9건은 PR을 만드는 시점에 아직 종료 요약이 없었다. 그 시점에 돌면 볼 게 없다.
그래서 Hook도, 여러 작업을 한꺼번에 훑는 범용 점검도 보류했다. 대신 작업을 끝내기 직전에 점검을 한 번 돌리고, 결과를 종료 기록에 한 줄 남기는 단계 하나만 넣었다. 선택지는 이 단계를 넣느냐, 아무것도 안 넣느냐 두 개였고 나는 넣는 쪽을 골랐다.
점검 스크립트는 일부러 작게 만들었다.
- 표준 라이브러리만 쓰는 파일 하나다.
- 누락이 있어도 종료 코드는 항상 0이다. 알려 줄 뿐 절차를 멈추지 않는다.
진입점은 이게 전부다. 입력이 깨져 있어도, 예상 못 한 예외가 나도 결과 한 줄을 찍고 0을 돌려준다.
def main(argv=None):
    parser = QuietParser(add_help=False, allow_abbrev=False)
    parser.add_argument("--records", required=True)
    try:
        line = result_line(evaluate(load_records(parser.parse_args(argv).records)))
    except Unavailable as error:
        line = result_line(reason=str(error))
    except Exception as error:  # every failure is reported, never raised
        line = result_line(reason=type(error).__name__)
    print(line)
    return 0
evaluate는 위 표의 네 항목을 I1~I4로 보고, 각각 confirmed, missing, undetermined 중 하나를 낸다. 스크립트 맨 위 설명에도 “confirmed는 기록에 그 항목이 있다는 뜻이지, 일을 했다는 증거가 아니다”라고 적어 뒀다.
그런데 리뷰에서 웃긴 게 나왔다. 기록을 읽는 정규식 몇 개가 입력이 길어지면 시간이 제곱으로 늘어서, 크기 상한에 가까운 입력에서는 수십 분 동안 멈출 수 있었다. “절차를 멈추지 않는다”는 점검이 절차를 멈출 뻔한 거다. 정규식을 고친 뒤에는 약 1.9MB짜리 입력도 0.27초에 끝났다.
실제로 돌려 보니 (10/14~10/15)
이틀 동안 실제 작업 15건이 끝나면서 점검이 돌았다.
종료 기록에 실제로 남은 줄은 이런 모양이다.
observation-check rules=v1 I1=confirmed I2=confirmed I3=confirmed I4=confirmed
observation-check rules=v1 I1=missing I2=confirmed I3=confirmed I4=missing
observation-check rules=v1 I1=confirmed I2=missing I3=confirmed I4=missing
이 줄 뒤에 “첫 실행 결과이고 다시 돌리지 않았다”, “기록 형식 진단이지 준수의 증거가 아니다” 같은 말이 붙은 기록도 있었다.
네 항목이 모두 “있음”으로 나온 건 3건뿐이다. 숫자만 보면 엉망이지만, 이걸 그대로 “Agent가 안 했다”로 읽으면 안 된다. 점검은 정해진 형식을 찾는 거라서, 표시 형식이 달라 못 읽은 것과 정말로 빠진 것이 섞여 있다. 손 시험에서 본 “표시 방식 다섯 가지”가 그대로 나온 셈이다. 이 둘을 가르는 일은 아직 안 했다.
같은 날 관측 재검토 Skill도 직접 한 번 실행했다. 종료된 작업 10건 중 5건, 기록 16개를 읽고 개선 후보 1건을 이슈로 만들었다.
그 후보가 재밌었다. “점검을 다시 돌렸으면, 첫 결과와 다시 돌린 이유를 남기자.” 점검에서 누락이 나오면 기록을 보충하고 다시 돌려서 “있음”을 만들 수 있다. 그러면 처음에 빠져 있었다는 사실이 사라진다. Agent가 자기 점검의 빈틈을 스스로 찾아낸 거다.
이 후보는 이슈가 만들어지고 20분쯤 뒤에 구현과 병합까지 끝났다. 10월 11일의 한 바퀴와 다른 점은, 이번엔 후보를 찾는 일까지 Agent가 했다는 거다. 다만 Skill을 부른 건 나였다.
사람 쪽에서 뺀 것: 서명 승인 (10/15)
이 사이에 반대 방향의 변경도 하나 있었다.
17편에서 기계로 넘긴 건 사실상 하나였다. 큰 작업(Large·Epic)의 승인은 사람이 자기 키로 서명한 태그로만 인정한다는 것. Agent가 사람 이름으로 승인 표시를 만든 사고가 계기였다.
17편을 올리고 이틀 뒤에 이걸 뺐다.
| 날짜 | 일 |
|---|---|
| 10/09 | 앱에 서명 승인 적용 |
| 10/13 | 17편 게시 |
| 10/14 | 서명한 뒤에 기록 누락이 발견돼 다시 서명하는 일이 생기자, 서명 전 준비 검사를 추가 |
| 10/15 | Large·Epic의 사람 승인·서명 단계 제거 |
이유는 그때 이슈에 적은 그대로다. 큰 작업마다 현황·계획 단계에서 내가 서명 태그를 만들어 올리고, 저장소 밖에 둔 승인 키 지문을 대조해야 했다. 혼자 운영하는 프로젝트에서 그 비용이 컸다. 게다가 18편에서 말한 절차 분리를 하려면, 서명 확인 검사를 앱 저장소와 규칙 저장소로 나누는 설계를 따로 해야 했다.
지금 내가 판단하는 곳은 두 군데다. 리뷰에서 “사람이 결정해야 한다”고 올라온 것, 그리고 PR 병합. 설계 리뷰와 코드 리뷰 방식은 그대로 뒀다.
솔직히 좀 머쓱하다. 17편의 “넘겼다: 승인 위조, 사람 키 서명” 줄은 이제 사실과 다르다. Agent가 사람 이름으로 결정을 만드는 문제는 서명이 아니라, 병합할 때 내가 보는 것과 남은 기록으로 다시 잡아야 한다.
관측이 못 잡은 것
같은 시기에 다른 종류의 문제도 드러났다. 관측 기록으로는 안 보이는 문제였다.
한 기능 작업에서 나는 “실제 모델 동작 검증이 필요한 부분은 비용에 맞게 골라서 하자”는 정도를 원했다. 그런데 계획을 거치면서 이게 이렇게 굳었다.
| 단계 | 계약 |
|---|---|
| 처음 계획 | 실제 API 호출 112회를 완료 조건으로 |
| 줄인 계획 | 결과 28개 전부 통과, 누적 비용 1,000원 상한 |
줄인 건 분명히 적응이었다. 다만 위험한 것만 병합 조건으로 두고 나머지는 따로 추적하는 대신, 작은 고정 집합을 전부 통과해야 하는 조건을 골랐다.
그 사이 서명을 요청한 계획서 판본이 여섯 개까지 나왔다. 그중 마지막은 내용은 그대로이고 기록 형식만 고친 것이었다. 처음 112회 계획도 리뷰는 통과했다. 리뷰는 계약대로 했는지를 보니까. 결국 막힌 걸 푼 건 내 지시였다. 실제로 쓴 평가 비용은 수백 원이었다.
전부 통과라는 조건 자체도 생각보다 빡빡하다. 예를 들어 결과 하나하나가 95% 확률로 통과하고 서로 독립이라고 쳐도, 28개가 한 번에 전부 통과할 확률은 약 24%다. 이 사례의 실제 확률은 아니고, 조건의 모양이 그렇다는 얘기다.
목적이 계약으로 굳어 가는 걸 지금의 관측 기록이 잡을 수 있을지는 아직 모른다. 조사는 해 뒀다. 결론은 새 규칙을 만들기보다, 기존 리뷰에서 목표·위험·대안을 짧게 비교해 보자는 쪽이다.
정리
| 한 것 | 결과 |
|---|---|
| 시작·인계·종료에 관측 기록 연결 | 채택 |
| 요구–검증 연결, 반복 기록 줄이기 | 채택. 효과 측정은 다음 단계 |
| 정기 배치로 Agent가 분석하고 이슈 생성 | 안 함 |
| PR 시점 알림 Hook, 범용 점검 | 손으로 해 본 뒤 보류 |
| 끝나기 직전 한 줄 점검 | 채택. 실제 15회 실행 |
| 서명 승인 | 사람이 뺌 |
Agent에게 방법론을 고치게 하면 규칙이 계속 늘 줄 알았다. 그런데 새로 생긴 장치는 부를 때만 도는 재검토 Skill과, 끝날 때 남기는 한 줄 점검 두 개뿐이다. 나머지는 이미 있는 기록에 붙이거나 덜 쓰게 하는 변경이었다. 크게 만들려던 정기 점검은 손으로 먼저 해 보고 접었다.
제목의 질문에 지금 답하자면, 이제 막 시작한 단계다. 한 바퀴는 돌았고, Agent가 자기 점검의 빈틈을 찾아낸 장면도 봤다. 이제 실제 작업에 적용했으니, 품질이나 비용이 정말 나아지는지 측정해서 확인해 볼 차례다. 지금까지는 한 프로젝트에서 일주일 동안 쌓인 기록이다.
그래서 다음에 할 일 두 가지를 이슈에 올려 두었다.
- 개선 조치마다 “무엇이 줄어야 하는지”를 한 줄로 미리 적고, 다음 재검토에서 맞았는지 대조한다.
- 13~16편에서 쓴 비교 실험장을 내리는 안. 13번 돌렸지만 효과를 판정할 만한 결론은 나오지 않았다. 앞으로는 필요할 때만 한 번씩 비교한다.
관련 글과 참고 자료: