이 시리즈는 작성 시점의 기록이다. 현재 기준은 Adaptive Agentic SDD 저장소에 정리해두었다.
README만 보고 첫 작업까지 가게 해 봤다
2026.11.07 게시 · 11월 1일에 써 둔 글
지난 글에서 방법론을 처음 공개하고 두 시간 만에 preview.2를 다시 낸 이야기를 적었다.
그 뒤로 2주 가까이 공개본은 그대로였다가, 10월 30일과 31일 이틀 동안 다섯 판을 더 냈다. 31일 밤에 낸 v1.0.0-preview.7이 이 글을 쓴 11월 1일 기준 판이다. 10월 31일에는 공개 저장소 main의 첫 화면도 바꿨다. 21편에서는 기존 사용자 때문에 main을 v0.2 그대로 뒀는데, 이번에 v1 소개를 위로 올리고 v0.2는 그 아래로 내렸다. v0.2는 기존 사용자를 위해 남겨 두지만 1.0과 같이 관리하지는 않는다. 그 뒤 1.0을 낸 이야기는 23편에 이어 적었다.
21편 끝의 “아직 안 한 것”에는 안내를 처음부터 끝까지 따라가 보는 것, macOS, 모델을 실제로 돌려 보는 행동 평가가 있었다. 이번 글은 그 셋을 해 본 이야기다. 그 전에 이 방법론이 무엇인지부터 짧게 적는다.
작은 변경은 짧게, 위험한 변경은 깊게
공개 README 첫 줄이 이 말이다. 1편에서 작업을 등급으로 나눈 것과 같은 생각이고, 9편에서 이걸 방법론으로 묶었다. v1에서는 등급마다 무엇을 거치는지를 표 하나로 정해 두었다.
작업 하나는 네 등급 중 하나를 받는다. 기준은 고치는 파일 수가 아니라 잘못됐을 때의 위험이다.
| 등급 | 언제 | 무엇을 거치나 |
|---|---|---|
| Trivial | 오타·링크·주석처럼 동작이 바뀌지 않는 수정 | 조건에 맞는지 스스로 점검하고, 바뀐 곳만 확인 |
| Small | 한 모듈 안의 변경 | 설계 문서 없이 작업 항목이 곧 명세. 완료 기준에 맞춰 스스로 리뷰 |
| Medium | 모듈 두 개 이상, 또는 프로젝트가 지정한 공유 계약 | 짧은 설계 문서. 프로젝트가 정하면 독립 리뷰 |
| Large | 보안, 개인정보, DB 스키마·마이그레이션, 백그라운드 재시도·스케줄, 과금·한도 | 현재 상태 분석과 구현 계획을 각각 두 번 리뷰받고(프로젝트가 한 번으로 줄일 수 있다), 코드는 독립 리뷰. 병합은 사람이 하거나 사람이 명시적으로 지시 |
README에 있는 두 예시가 이 차이를 잘 보여 준다. 문서의 깨진 링크는 Trivial로 받아서, 고치고, 링크가 열리는지 확인하고 끝난다. payments 테이블에 환불 사유 컬럼을 더하는 일은 DB 스키마 변경이라 자동으로 Large가 되고, 분석과 리뷰와 검사를 다 거친 뒤 “병합은 직접 하거나 명시적으로 지시해 달라”며 멈춘다.
Agent는 이런 자동 격상을 스스로 낮추지 못한다. 20편에서 남긴 사람 판단도 그대로 들어 있다. 범위를 줄이는 일, 위임, Large 병합, 새 제품 결정은 Agent가 정하지 않고 멈춰서 묻는다.
첫 화면을 다시 썼다
preview.3~5는 주로 안쪽을 고친 판이다. preview.3에서 등급을 Trivial·Small·Medium·Large 넷으로 정리하고, Epic은 등급이 아니라 작업을 묶는 단위로 바꿨다. preview.5에서는 21편 때 비어 있던 영어판에 절차와 설치 도구를 채웠다.
preview.6에서는 README를 처음 온 사람 기준으로 다시 썼다. 첫 화면에 남긴 건 이 순서다. 무엇인지, 등급에 따라 깊이가 어떻게 달라지는지, 예시 두 개, 붙여 넣을 설치 프롬프트, 성공하면 나오는 출력, 추가되는 파일, 되돌리는 법, 첫 작업과 언제 끝난 걸로 보는지. 그동안 README에 쌓여 있던 검증 이력은 변경 기록으로 옮겼다.
설치는 빠른 시작에 있으니 여기서 반복하지 않는다. Agent에게 프롬프트 하나를 붙여 넣으면, Agent가 저장소를 살펴 설정 초안을 내고 사람만 정할 값은 묻는 흐름이다. 그중 가장 중요한 질문은 변경 범위별로 무엇을 돌려 검증할지다. 이걸 정하지 않으면 완료 기준을 증명할 방법이 없어서 구현이 멈춘다.
README만 주고 따라오게 했다
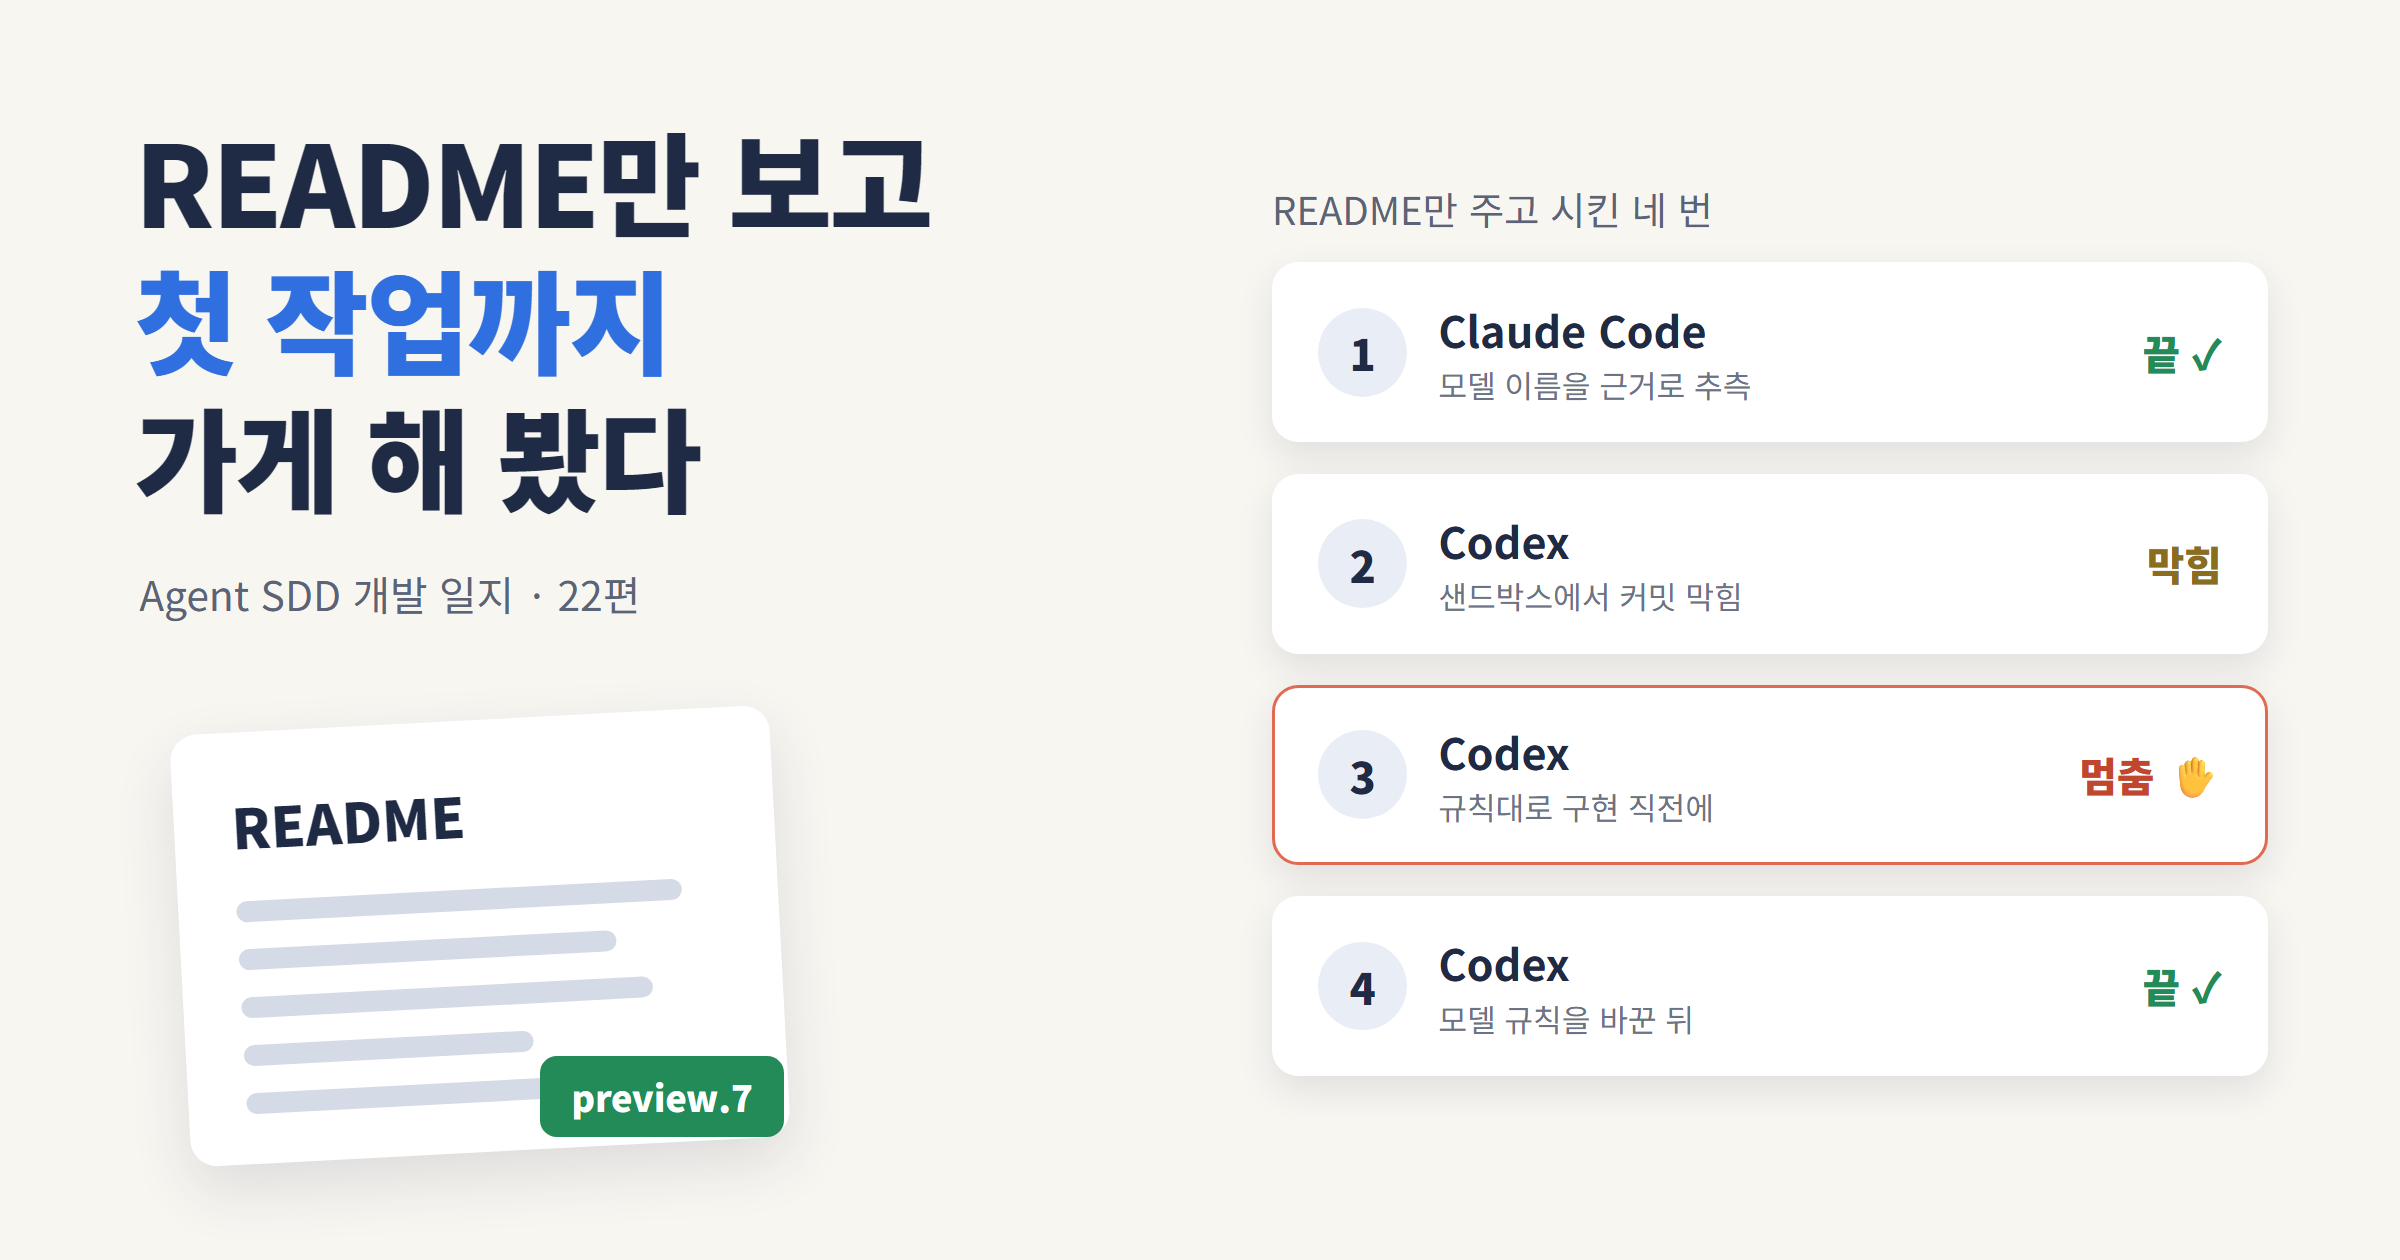
README를 바꿨으면 정말 그것만 보고 따라올 수 있는지 봐야 했다. 새 Agent 세션에 README와 설치 안내만 주고, 일회용 저장소에서 세 가지를 시켰다. 설치하고 커밋하기, README의 첫 작업(한 모듈 안의 작은 버그를 고치고 회귀 테스트 더하기), 그리고 설치 되돌리기. 사람이 답할 값은 프롬프트에 미리 적어 줬다.
| 실행 | 설치 | 첫 작업 | 되돌리기 |
|---|---|---|---|
| 1. Claude Code, 영어판, preview.6 후보 | 끝 | 끝 | 끝 |
| 2. Codex, 한국어판, preview.6 후보 | 설치는 됐지만 커밋에서 막힘 | 시작 못 함 | 막힘 |
| 3. Codex, 한국어판, 공개된 preview.6 | 쓰기 경로를 열어 준 뒤 끝 | 구현 직전에 멈춤 | 끝 |
| 4. Codex, 한국어판, 규칙을 바꾼 후보 | 끝 | 끝 | 끝 |
2번과 3번이 처음 막힌 곳은 Codex 샌드박스였다. Codex의 workspace-write 샌드박스에서는 .agents/와 .git이 읽기 전용이다. 2번은 커밋에서, 3번은 처음 시도 때 Skill 입구 파일을 쓰는 단계에서 막혔다. 첫 작업도 worktree를 만들고 커밋하고 병합하니 같은 곳에서 막힌다. README에 이 경로를 여는 방법과, 그래도 Git 쓰기가 거부되면 그 명령은 사람이 직접 하라는 안내를 넣었다.
규칙을 지킨 쪽이 멈췄다
더 눈에 띈 건 1번과 3번이다.
방법론에는 단계마다 어떤 모델에게 일을 맡길지 정하는 규칙이 있다. 그 규칙대로라면, 지금 대화 중인 모델이 직접 구현하려면 “이 모델이 그 단계를 맡을 만하다”는 최근 근거가 있어야 했다. 그런데 막 설치한 프로젝트에는 그런 기록이 하나도 없다. README도 안내도 무엇이 그 근거인지 말하지 않았다.
3번 Codex는 규칙대로 구현 직전에 멈췄다. 1번 Claude Code는 끝까지 갔는데, 스스로 남긴 보고를 보면 호스트가 알려 준 모델 이름이면 충분하다고 해석했다. 규칙에 없는 추측이다.
규칙을 지킨 쪽은 첫 작업에서 멈추고, 추측한 쪽은 끝까지 갔다. 처음 쓰는 사람에게는 첫 작업부터 막히는 방법론이었던 셈이다.
문구를 다듬어서 풀 문제는 아니었다. 무엇을 근거로 볼지를 바꾸면 규칙의 뜻이 달라진다. 그래서 따로 판단해서 이렇게 바꿨다.
- 일상적인 Trivial·Small 작업은 거부된 모델이 아니면 지금 모델로 진행한다. 역량 근거를 따로 요구하지 않는다.
- 그 밖에 지금 모델이나 사람이 고른 모델로 하는 작업에는 최근 근거가 있거나, 관찰 결과를 인용해 사람이 확인한 평가가 있어야 한다.
- 다른 모델로 자동으로 바꾸거나 일을 넘기는 경우, 거부된 모델과 오래된 기록을 다루는 규칙, 사람 판단 요건은 전과 같다.
변경 기록에도 문구 수정이 아니라 규칙을 푼 변경이라고 적었다. 바꾼 후보로 돌린 것이 4번이다. 역량 기록이 빈 채로 Codex가 첫 작업을 끝까지 마쳤다. 실패하는 회귀 테스트를 먼저 쓰고, 고치고, 모듈 테스트와 전체 테스트를 돌리고, 병합하고, 작업을 닫았다.
다만 한 번 된 것이다. 얼마나 자주 되는지, 다른 코드베이스에서도 되는지는 재지 않았다. 네 번 모두 Windows 한 대에서 사람 답을 미리 준 상태로 돌렸고, 병합은 일회용 로컬 저장소에 했다. 실제 GitHub 이슈와 PR로는 해 보지 않았다.
macOS에는 python이 없었다
21편까지 시운전은 Windows에서만 했다. 이번엔 macOS에서도 따라가 봤다.
테스트 88개 중 하위 테스트 두 개가 실패했다. 설치 도구가 만들어 주는 검사 명령이 python을 불렀는데, 그 Mac에는 python3만 있었다. 소스는 그대로 두고 python 별칭만 잡아 주자 88개가 모두 통과했다.
그래서 preview.7에서는 macOS·Linux용으로 만드는 검사 명령이 python3를 쓰게 바꿨다. Windows PowerShell용은 python 그대로다. 고친 커밋을 같은 Mac에서 python 없이 다시 돌려 테스트 89개가 모두 통과했다.
이 macOS 진행에서 설치, Small 작업 수정과 병합, 되돌리기까지 마쳤다. 하지만 처음 쓰는 사람의 기록으로 보기는 어렵다. 진행한 Agent가 예상되는 걸림 지점을 적은 메모를 미리 읽었고, 네트워크 문제로 파일을 다른 경로로 받아 해시로 맞춰 복원하는 우회도 거쳤다.
시험지 옆에 답안지가 있었다
21편에서는 Skill이 기대한 대로 행동하는지 모델을 돌려 보는 평가를 하지 않았다. 이번에 처음 돌렸다. 한국어 사례 12개를 Claude Code와 Codex에 세 번씩 돌리고, 서로의 답을 채점하게 했다.
| 통과 | 실패 | 무효 | |
|---|---|---|---|
| Claude Code | 21 | 14 | 1 |
| Codex | 22 | 14 | 0 |
실패 중 일부는 사례 쪽 문제였다. 한 사례는 기대하는 멈춤 문구가 Skill보다 낡아 있어서, Skill대로 답한 두 도구의 여섯 번이 모두 실패로 채점됐다. 점수는 그대로 두고 사례만 고쳤다.
더 큰 구멍은 따로 있었다. 실행기가 방법론 묶음을 통째로 평가 대상 프로젝트에 복사했는데, 그 안에 사례 파일이 들어 있었다. 사례마다 해야 할 행동과 하면 안 되는 행동을 적은, 말하자면 채점 기준이다. 평가받는 Agent가 그 파일을 읽을 수 있었다. 접근을 막지도 기록하지도 않았으니 실제로 읽었는지는 모른다. 읽었다고 단정할 수는 없지만, 읽었을 수도 있는 결과를 깨끗한 근거로 내세울 수도 없다. preview.6 때 한 작은 확인(통과 4, 실패 6)도 같은 상태였다.
그래서 점수는 기록된 그대로 두고, README의 상태 절에는 깨끗한 근거가 아니라고 고쳐 적었다.
정답 파일을 빼고 돌리는 새 실행기도 만들었다. 그걸로 이번에 바꾼 모델 규칙을 확인해 봤더니 또 다른 구멍이 나왔다. 새 실행기가 Codex의 파일 읽기 기능까지 꺼 버려서, Codex는 Skill과 규칙을 하나도 읽지 못한 채 답했다. 그러니 Codex 쪽 결과는 방법론에 대한 근거가 아니다. Claude 쪽도 정상 진행을 기대한 사례에 작업 번호가 빠져 있어서, 바뀐 규칙은 제대로 적용하고도 다른 이유로 멈췄다. 부분적인 근거에 그친다. 이번 판에서는 실행기를 고치지도, 다시 돌리지도 않았다.
점수를 얻는 것보다 그 점수가 무엇을 쟀는지 확인하는 게 먼저였다. 이번엔 그 확인이 점수보다 늦었다.
preview.7 때 확인된 것과 아닌 것
- 설치와 테스트: Windows와 macOS에서 확인했다. Windows에서는 테스트 89개가 모두 통과했고, 한국어·영어 두 판을 작업 관리 방식 두 가지(GitHub, 로컬 문서)로 설치해 검사까지 통과했다. macOS는 위의 수정 뒤 89개 통과.
- 첫 작업까지 끝낸 실행: 있다. 다만 Windows 한 대에서 사람 답을 미리 준 몇 번과, 미리 정보를 읽은 macOS 진행 한 번이다. 실제 GitHub 이슈·PR 작업은 하지 않았다.
- 행동 평가: 약한 근거다. 답안지 노출, 실행기 결함, 사례 결함이 섞여 있다.
- 효과: 재지 않았다. 결과가 나아지는지, 재작업이나 비용이 줄어드는지 모른다.
이건 Agent와 사람을 위한 안내다. 보안 경계도, Agent를 대신 돌려 주는 실행기도 아니다.
세부는 공개 저장소의 기록(영문)에 있다. 첫 사용 실행, macOS 진행, 첫 행동 평가, 바뀐 모델 규칙 확인, 그리고 변경 기록.
정리
| 한 것 | 결과 |
|---|---|
| 첫 화면 | README를 처음 온 사람 기준으로 다시 쓰고, main 첫 화면도 v1으로 바꿨다 |
| README만 주고 따라오게 하기 | 네 번 중 두 번 첫 작업까지 끝냈다. 규칙을 지킨 실행은 구현 직전에 멈췄다 |
| 모델 규칙 | 일상적인 Trivial·Small은 근거 없이 지금 모델로. 나머지는 그대로 |
| macOS | 검사 명령을 python3로 고치고 89개 통과 |
| 행동 평가 | 처음 돌렸지만 답안지가 보이는 상태였다. 깨끗한 근거가 아니다 |
| 효과 | 재지 않았다 |
README를 아무리 다듬어도, 그걸 따라오는 Agent가 어디서 멈추는지는 직접 시켜 봐야 보였다. 이번 판에서 뜻이 가장 크게 바뀐 규칙도 첫 사용에서 멈춘 자리에서 나왔다.
직접 써 볼 사람이 있다면 등급이 맞았는지, 작은 변경에서 어떤 절차가 부담이었는지, 설치나 첫 작업이 어디서 멈췄는지 이슈로 남겨 주면 좋겠다. 쓴 태그와 환경, 멈춘 지점을 같이 적어 주면 규칙의 문제인지 환경의 문제인지 가르기 쉽다.
관련 글과 참고 자료: