하네스의 보조 절차 하나만 빼고 돌려봤다
2026.10.02 게시
이 시리즈는 작성 시점의 기록이다. 현재 기준은 Adaptive Agentic SDD 저장소에 정리해두었다.
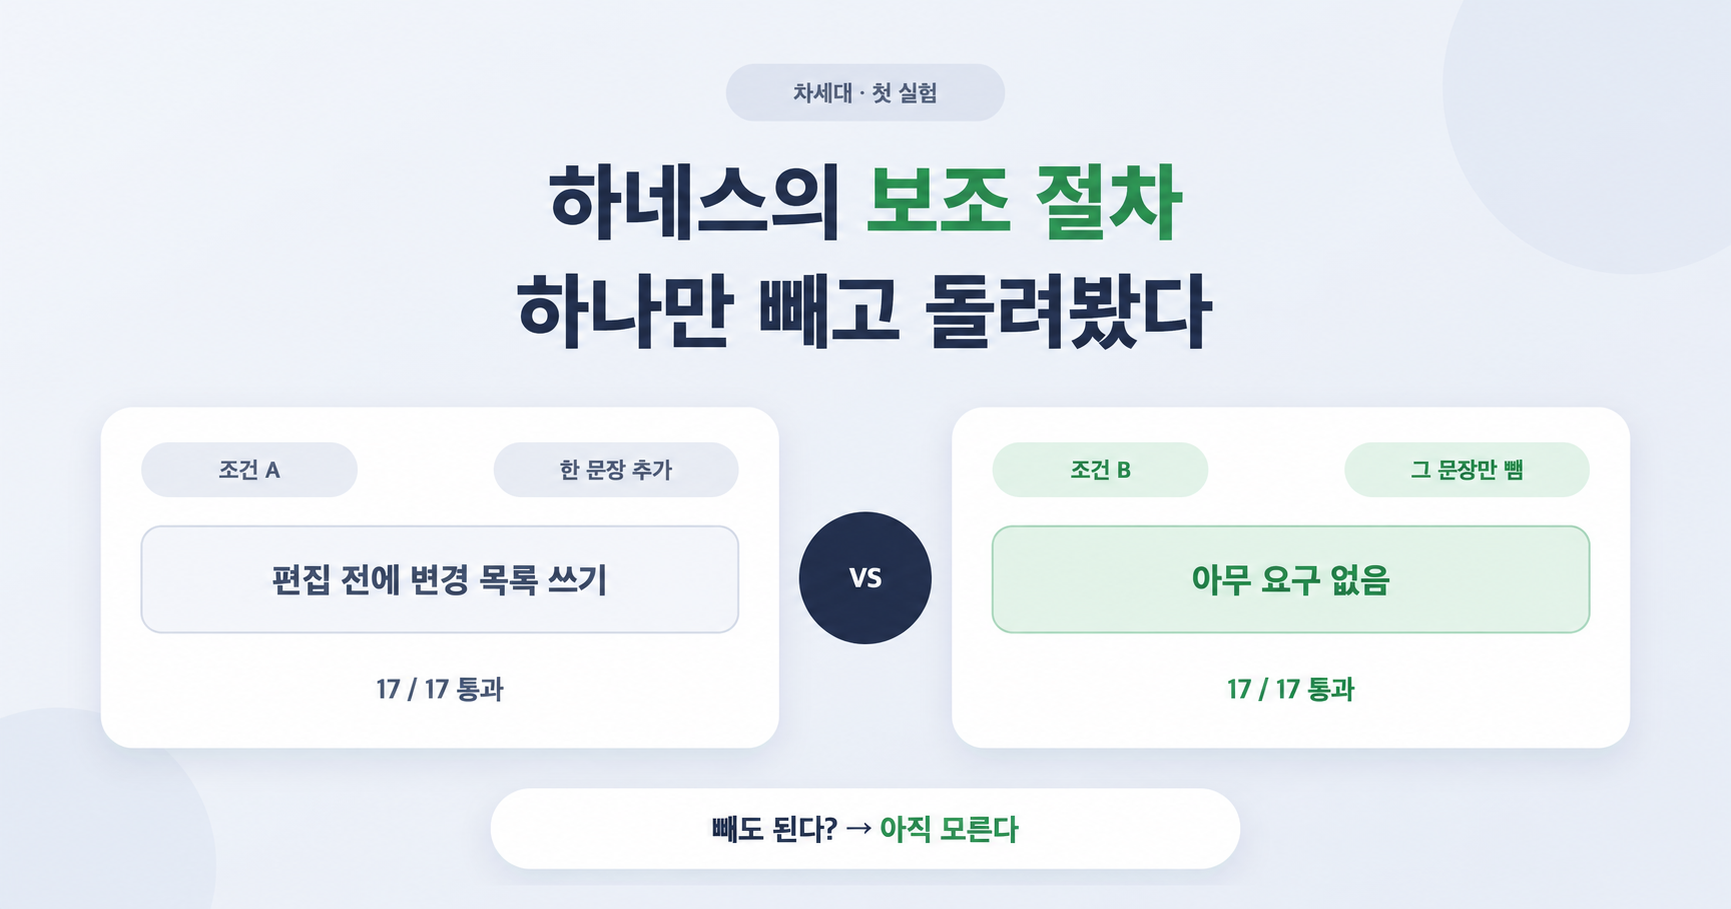
지난 글에서 순서를 하나 정했다. 하네스를 고치기 전에 먼저 재본다. 지금 쓰는 모델이 그 절차 없이도 누락을 안 하는지 보고, 그다음에 줄일지 말지를 정한다.
말은 쉬운데 막상 재려고 하니 정할 게 많았다.
그리고 한 가지를 먼저 인정해야 했다. 나는 이미 “하네스의 보조 절차가 과하다”는 쪽으로 기울어 있었다. 그 상태로 실험을 하면 보고 싶은 결과를 보게 된다. 이번 글에 나오는 번거로운 규칙들은 대부분 그걸 막으려고 넣은 것이다.
한꺼번에 다 떼지 않는다
제일 먼저 떠오르는 방법은 방법론을 적용한 쪽과 적용하지 않은 쪽으로 나눠서 같은 작업을 시키는 것이다.
이건 두 가지가 문제였다.
결과가 달라져도 뭐 때문에 달라졌는지 알 수 없다. 절차가 열 개인데 열 개를 한꺼번에 빼면, 그중 어느 게 받쳐주고 있었는지는 여전히 모른다.
그리고 방법론을 통째로 빼면 권한, 수정 범위, 꼭 돌려야 하는 검증까지 같이 빠진다. 지난 글의 비유로 하면 보조바퀴를 떼겠다면서 헬멧까지 벗기는 셈이다.
그래서 이렇게 나눴다.
| 양쪽에 똑같이 둔 것 | 한쪽에서만 뺀 것 | |
|---|---|---|
| 성격 | 통제 (헬멧) | 보조 절차 (보조바퀴) |
| 내용 | 수정해도 되는 파일, 금지 사항, 돌려야 하는 검사, 결과를 정직하게 보고할 것 | 보조 절차 하나 |
첫 번째로 고른 보조바퀴
고른 건 “편집 전에 변경 목록 쓰기”다.
편집을 시작하기 전에 변경할 파일·심볼과 그 변경 순서를
관찰 가능한 짧은 목록으로 작성한다.
기존 방법론의 변경 계획 단계에 있던 절차를 한 문장으로 줄인 것이다.
이걸 고른 이유는 둘이다.
막으려는 실수가 분명하다. 바꿔야 할 곳을 빠뜨리는 것이다. 지난 글에서 “지금 모델이 누락을 하는지 재겠다”고 했으니 누락을 겨냥한 절차부터 보는 게 맞았다.
그리고 떼어내기 쉽다. 이 한 문장은 권한이나 검증을 건드리지 않고 뺄 수 있었다. 계획 단계를 통째로 빼는 것도 생각했는데, 그러면 완료 조건 확인까지 같이 빠져서 접었다.
B에게 “계획하지 마라”고 하지는 않았다. 스스로 목록을 쓰는 건 자유다. 내가 알고 싶은 건 모델이 계획을 하느냐가 아니었다. 목록을 쓰라고 요구하는 것이 결과를 바꾸느냐였다.
과제와 채점은 결과를 보기 전에 고정했다
과제는 실험용으로 새로 만들었다. CSV로 된 독서 기록을 읽어서 제목별 쪽수를 합치고, 기준 이상인 것만 정렬해서 출력하는 작은 프로그램이다.
| 항목 | 내용 |
|---|---|
| 고칠 파일 | 2개 |
| 완료 조건 | 11개 |
| 검사 | 17개 |
| 누락이 날 만한 곳 | 입력 파싱, 집계, CLI 출력을 같이 바꿔야 한다 |
채점기부터 믿을 수 있는지 봤다.
| 넣어본 것 | 채점 결과 |
|---|---|
| 정답 코드 | 17개 모두 통과 |
| 손대지 않은 초기 코드 | 17개 중 14개 실패 |
| 일부러 결함을 넣은 코드 8종 | 전부 잡아냄 |
그리고 결과가 나오기 전에 판정 규칙을 적어뒀다.
비유 · 답안지를 보기 전에 채점 기준부터. 답안지를 먼저 보고 채점 기준을 만들면, 마음에 드는 답이 정답이 된다. 나는 이미 “빼도 된다” 쪽으로 기울어 있었기 때문에, 결과를 본 뒤에 기준을 정하면 그쪽으로 끌고 갈 게 뻔했다.
| 두 쌍의 결과 | 미리 정한 판정 |
|---|---|
| 환경 문제나 채점기 결함이 있었다 | 보류 |
| 두 쌍 모두 A만 통과 | 이 절차는 유지하는 쪽으로 다음 실험 |
| 두 쌍 모두 B만 통과 | 이 절차가 맞지 않을 가능성을 다시 검토 |
| 두 쌍 모두 양쪽 통과 | 차이를 못 본 것. 같다고 확인한 건 아님 |
| 그 밖의 조합 | 근거 부족으로 보류 |
차이가 작다고 횟수를 늘리지 않는다는 것도 같이 적었다. 원하는 결과가 나올 때까지 돌리게 되기 때문이다.
실행 조건은 이렇게 잡았다.
| 항목 | 값 |
|---|---|
| 모델 | GPT-5.6 Sol, 추론 수준 medium |
| 횟수 | 4회 (A → B → B → A) |
| 시간 | 전체 30분 |
| 비용 | 구독 범위 안에서만. 추가 과금 없음 |
모델은 요청한 값 기준이다. CLI가 실제로 어떤 모델이 응답했는지까지 따로 확인해주지는 않았다. 실패한 호출도 4회에 포함하기로 했다.
결과
첫 번째 실행은 모델이 못한 게 아니다. 실행 환경이 막혀 있어서 편집 자체를 시작하지 못했다. 이 이야기는 다음 글에서 따로 한다.
나머지 세 번은 모두 통과했다. 세 번 다 한 번에 고쳤고, 검사가 실패해서 다시 고친 횟수는 0이다.
눈에 띈 건 B였다. 목록을 요구하지 않았더니 두 번 다 목록 없이 바로 작업했고, 그러고도 누락 없이 끝냈다.
그래서 빼도 되나
아직은 못 뺀다.
결과만 보면 “봐라, 없어도 되잖아”라고 쓰고 싶어진다. 그런데 미리 적어둔 규칙에 걸렸다.
| 걸린 점 | 왜 문제인가 |
|---|---|
| 첫 쌍은 환경 문제로 비교가 안 된다 | 쓸 수 있는 비교가 한 쌍뿐이다 |
| 그 한 쌍에서 양쪽이 통과했다 | “차이를 못 봤다”이지 “같다”가 아니다 |
| 모델 하나, 과제 하나다 | 다른 모델, 더 큰 작업에 대해서는 아무 말도 못 한다 |
| 과제가 쉬웠을 수 있다 | 아래에서 따로 |
마지막이 제일 크다.
비유 · 평지에서만 타본 자전거. 보조바퀴를 떼고 넓은 평지 직선에서 타보면 웬만하면 안 넘어진다. 그걸로 “이제 떼도 된다”고 하기는 어렵다. 넘어지는 건 코너나 내리막에서다. 이번 과제는 평지였을 가능성이 크다.
완료 조건과 검사를 모델에게 그대로 줬으니, 그 자체가 체크리스트 역할을 했을 수도 있다. 목록을 따로 쓰지 않아도 빠뜨릴 게 없었던 것이다.
지난 글에서 언급한 Anthropic의 하네스 글에도 같은 이야기가 있다. 모델이 좋아지면 “혼자 안정적으로 해내는 범위”가 넓어지고, 보조 장치는 그 범위 바깥에 있는 작업에서만 값을 한다는 것이다. 범위 안쪽 작업으로 재면 뭘 붙이든 떼든 결과가 같다.
그래서 판정은 보류했고, 이 보조 절차는 그대로 둔다.
남은 것
결론은 못 얻었지만 얻은 게 없지는 않다.
| 얻은 것 | 내용 |
|---|---|
| 재는 방법 | 통제는 고정하고, 보조 절차 하나만 바꾸고, 판정 규칙은 결과 전에 적는다 |
| 다음에 잴 곳 | 모델이 넉넉히 하는 과제 말고, 아슬아슬한 과제 |
| 비용 감각 | 네 번 호출하고 결과를 저장하기까지 18분 22초. 그중 모델이 실제로 일한 시간은 합쳐서 5분 남짓 |
마지막 줄이 생각보다 무거웠다. 나머지 13분은 환경을 고치고, 다시 검사하고, 로그를 확인한 시간이다. 과제와 채점기를 만든 시간은 여기에 들어 있지도 않다.
보조 절차 하나를 재는 데 이만큼 든다. 모든 절차를 모든 모델에 대해 이런 식으로 재는 건 현실적이지 않다. 어디를 재고 어디는 그냥 둘지도 정해야 한다는 뜻이다.
그리고 이번 실험을 실제로 멈춰 세운 건 모델이 아니었다. 다음 글은 그 이야기다.
관련 글과 참고 자료: